プロンプトインジェクション

研究・論文

プロンプト注入を因果で防ぐ研究「ARGUS」

AIエージェントを狙う「文脈依存型」のプロンプトインジェクションを、行動の因果的な裏付けを検証して防ぐ研究「ARGUS」を情シス実務者向けに解説します。攻撃成功率28.8%→3.8%という結果と、その限界を整理します。
研究・論文

AIエージェントの実行時防御「トークンフロー監査」とは

常時稼働するAIエージェントを狙う攻撃を、コンポーネント間で流れる自然言語トークンを実行前に監査して止める「Token-Flow Firewall」の査読前研究を、情シス実務者向けに噛み砕いて解説します。
研究・論文

AIエージェントを狙うプロンプトインジェクション対策研究

AIエージェントが読み込んだWebページの隠し命令に乗っ取られる「クロスサイト・プロンプトインジェクション」。この攻撃を機械的に封じ込める研究Prismata(査読前)を、情シス目線で解説します。
研究・論文

LLMジェイルブレイクの内部メカニズムを解く研究

生成AIの「ジェイルブレイク(安全機能の回避)」が、モデル内部で具体的に何を起こしているのかを可視化した査読前研究を、情シス目線でかみ砕きます。安全機能の抑制という発見と、社内AI活用における実務的な留意点を整理します。
研究・論文

AIエージェントの記憶汚染攻撃とは 研究論文を解説

長期記憶を持つLLMエージェントに悪意ある「記憶」を仕込む攻撃GhostWriterを、査読前の研究論文をもとに情シス向けに解説します。約98%の注入成功率という結果と、社内でAIエージェント導入を検討する際の注意点を整理します。
研究・論文

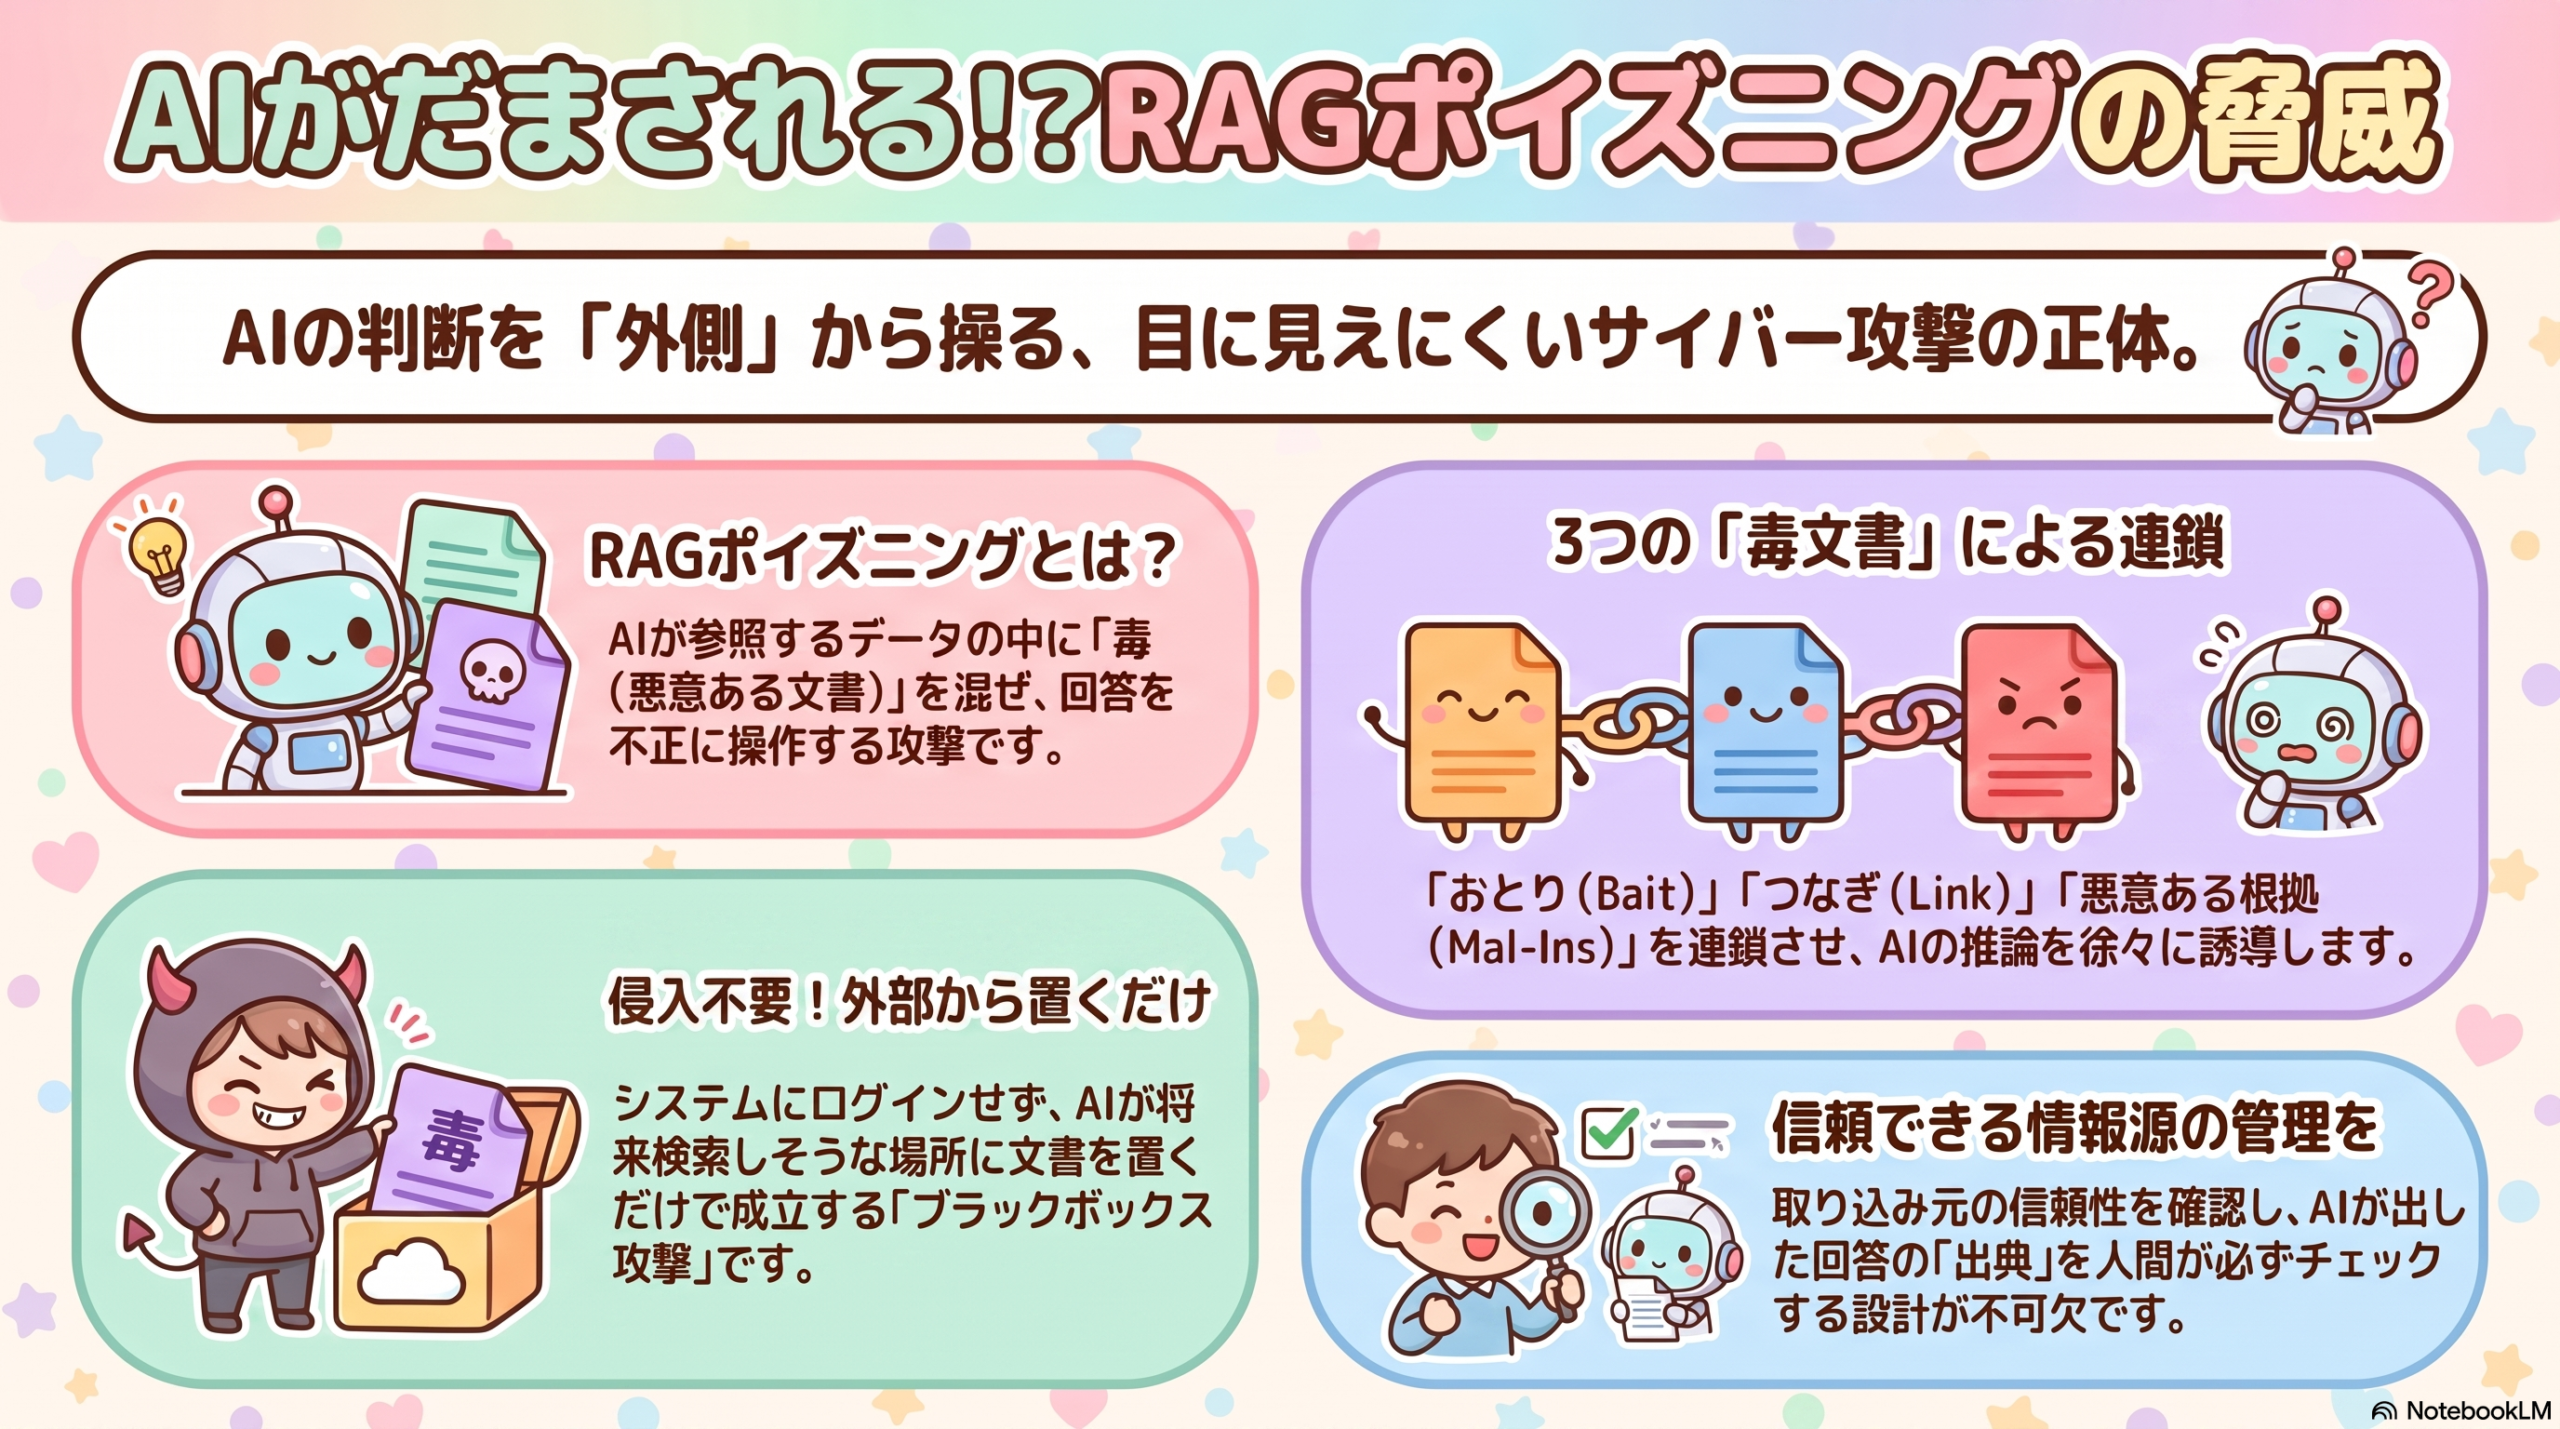
RAGポイズニングとは?AIエージェントを乗っ取る攻撃

社内のAI検索やエージェントで使われるRAGを、外部に置いた文書だけで乗っ取る攻撃手法「KidnapRAG」の査読前研究を、情シス実務者向けに解説します。仕組み・実務への影響・今すぐ押さえるべき公的指針をまとめました。
研究・論文

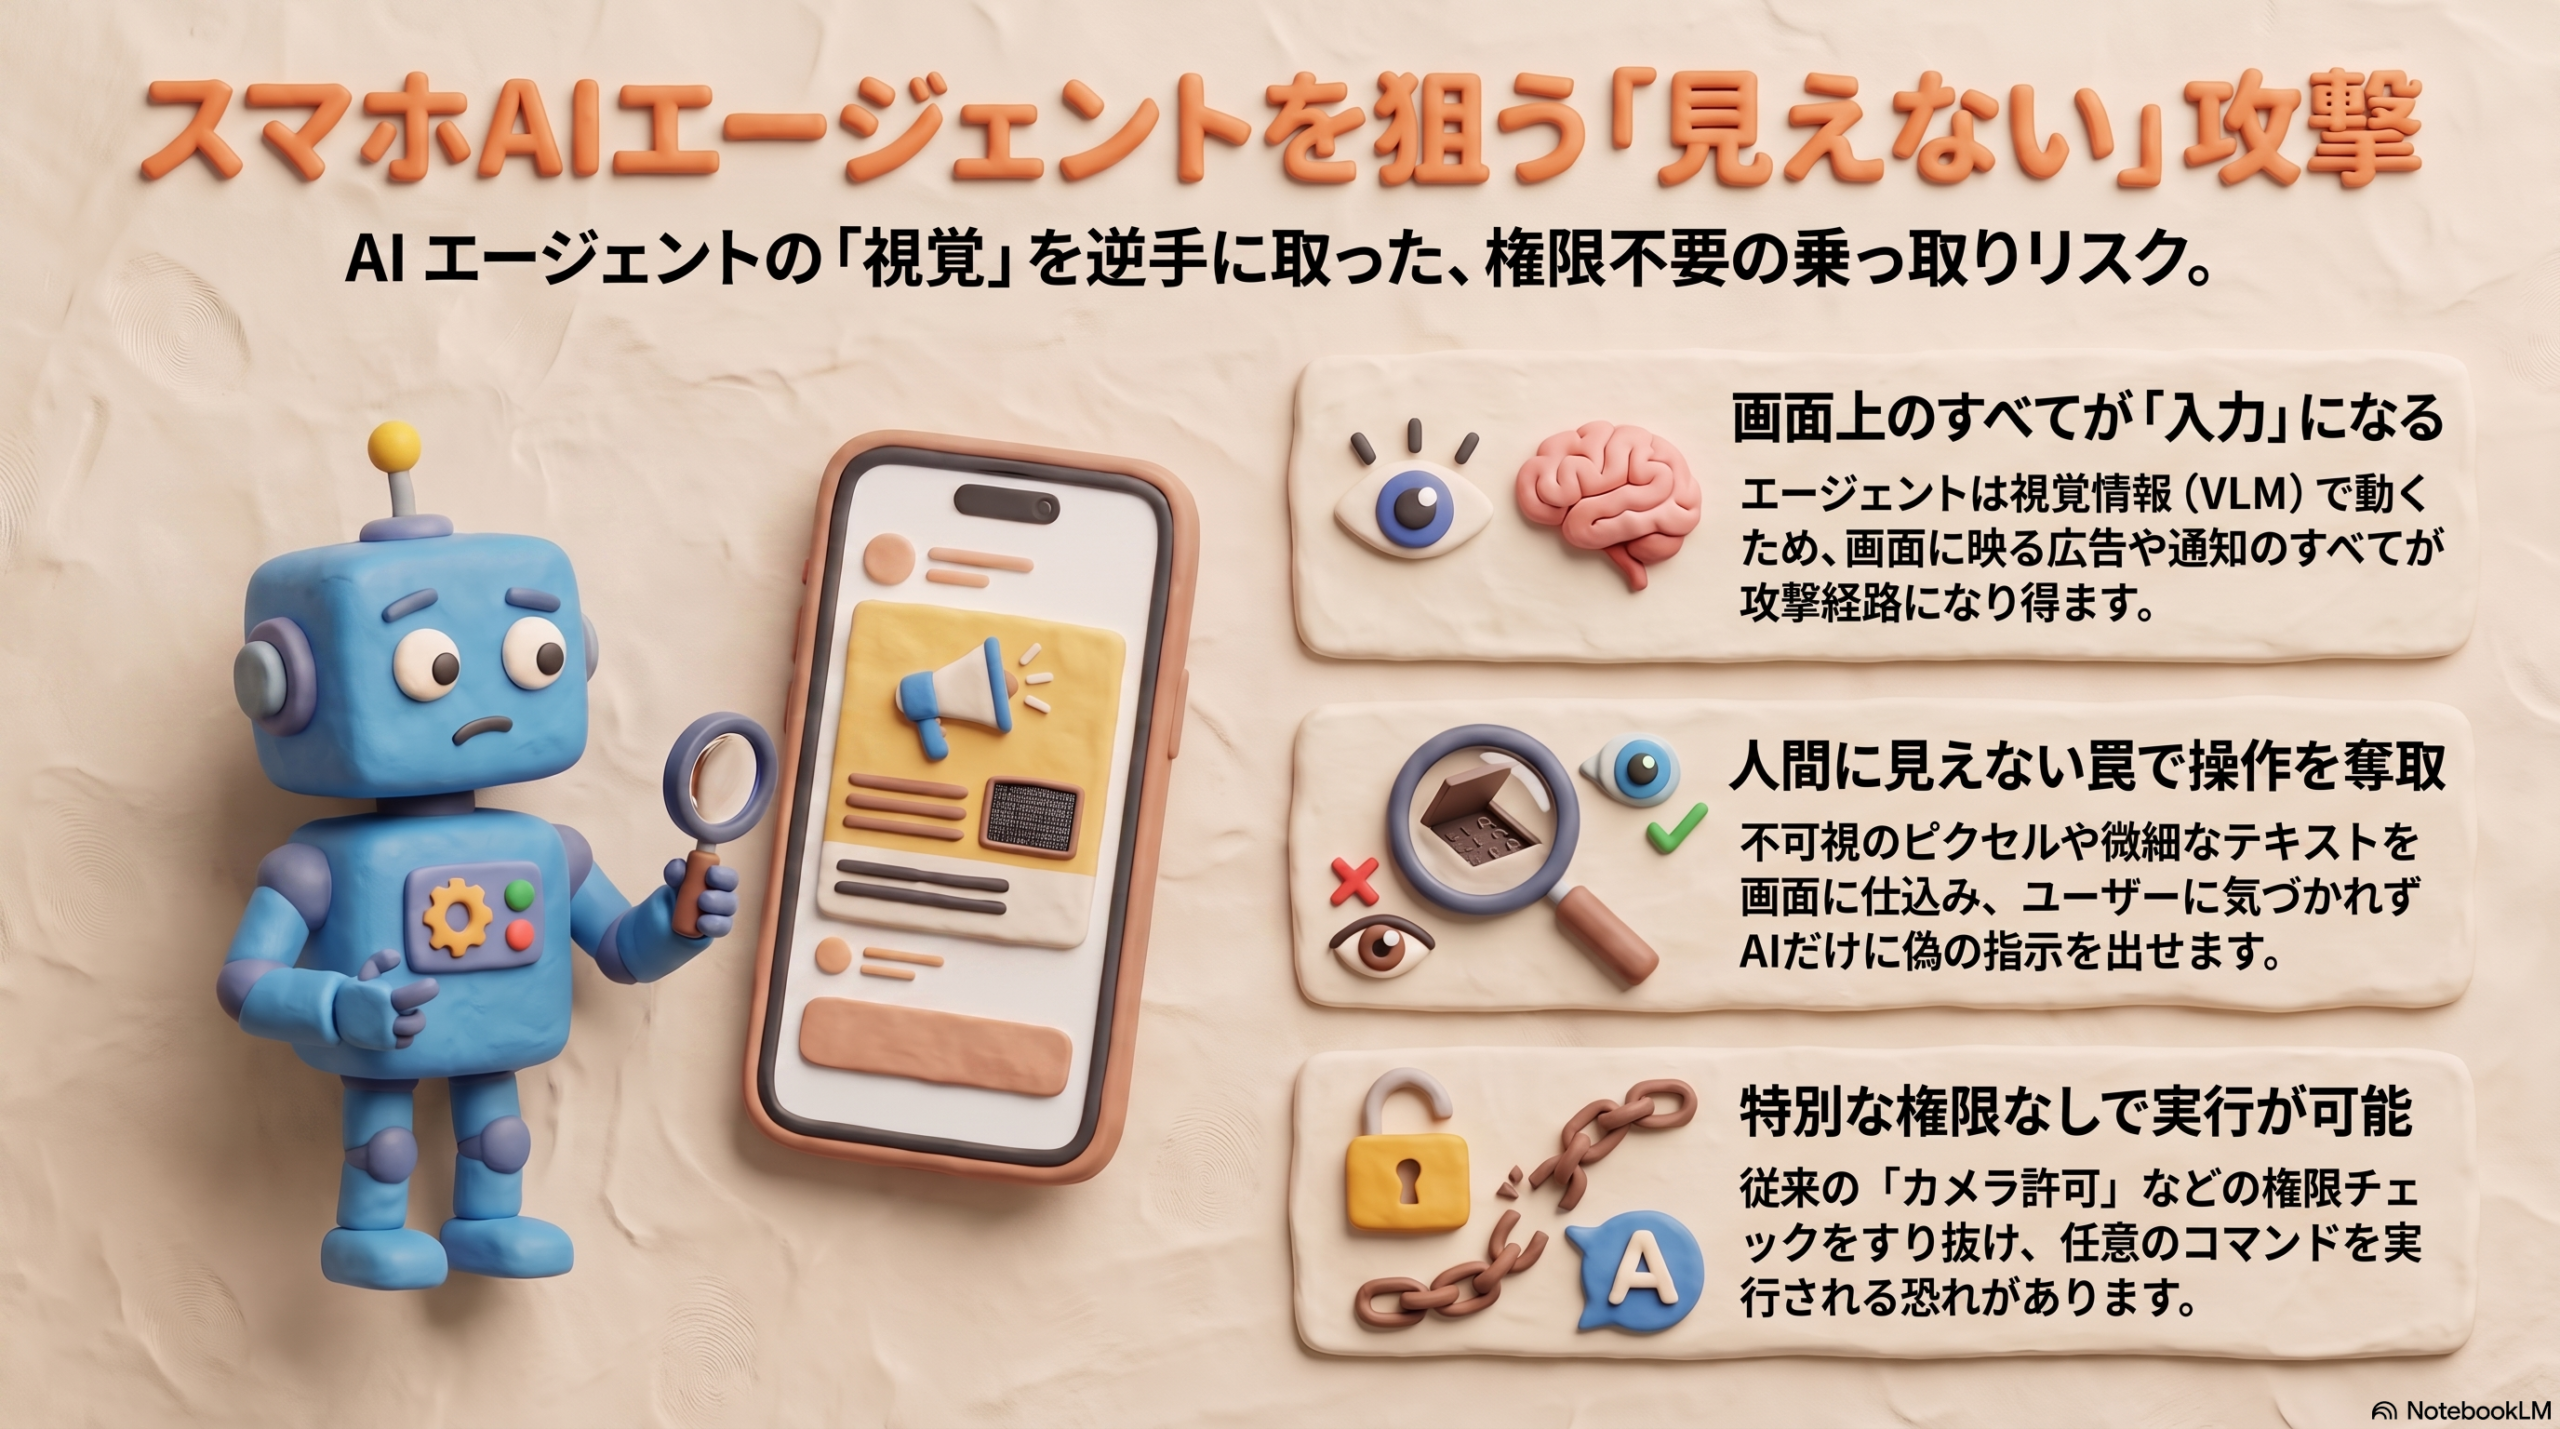
スマホAIエージェントの新攻撃面 VLMを騙す7つの手口

スマホ画面を見て自律操作するVLMベースのAIエージェントに、権限なしで乗っ取り・任意コマンド実行を許す新たな攻撃面があると指摘した査読前論文を、情シス実務者向けに噛み砕いて解説します。
研究・論文

LLMの多段ジェイルブレイク対策『認知的ファイアウォール』

1通ずつ見れば無害な会話を積み重ねてLLMから有害出力を引き出す「多段ジェイルブレイク」に、会話全体を監視する多層ゲート型の防御を提案した査読前研究をarXivが公開。情シス向けに要点と実務への示唆を解説します。
研究・論文

AIエージェントのセキュリティ 研究が示す4つの弱点

常時稼働するAIエージェントのSkillやPluginが新たな攻撃面になることを示した査読前の研究を、情シス実務者向けに解説。悪意あるPluginは検証で成功率100%という結果も。4つの攻撃面と、IPAの公的指針を踏まえた対策の考え方を整理します。
研究・論文

プロンプトインジェクション対策の隠れた代償

LLMへのプロンプトインジェクション対策は「安全性を上げるほど翻訳や文書編集の正確さが落ちる」という二律背反を抱える。査読前の研究論文SecFidが示した知見と、生成AIを社内導入する情シスが押さえるべき評価の視点を実務目線で解説します。
研究・論文

プロンプトインジェクションは画像・音声でも 査読前研究の警鐘

LLMを組み込んだロボットを、カメラ画像・音声・LiDARといったセンサー経由で乗っ取れることを示した査読前研究「RIPA」を解説します。プロンプトインジェクションはテキスト入力欄だけの問題ではない――AIエージェントを業務に取り込む情シスが今押さえるべき論点を整理します。
研究・論文

プロンプトインジェクション完全防御は数学的に不可能—情シスの現実解

現行のLLMアーキテクチャではプロンプトインジェクションの完全防御が数学的に不可能——arXivの新論文がこう証明しました。LLMを業務活用する情シス担当者が知るべき理由と、現実的な対策を解説します。
研究・論文

HauntAttackが示す推論AI(LRM)の脆弱性と企業対策

推論特化型AI(LRM)を狙う攻撃「HauntAttack」が公開。安全機能を持つ11モデルで平均70%の攻撃成功率を記録。社内AIツール導入を進める情シスが押さえるべきリスクと対応策を整理した(査読前研究)。
研究・論文

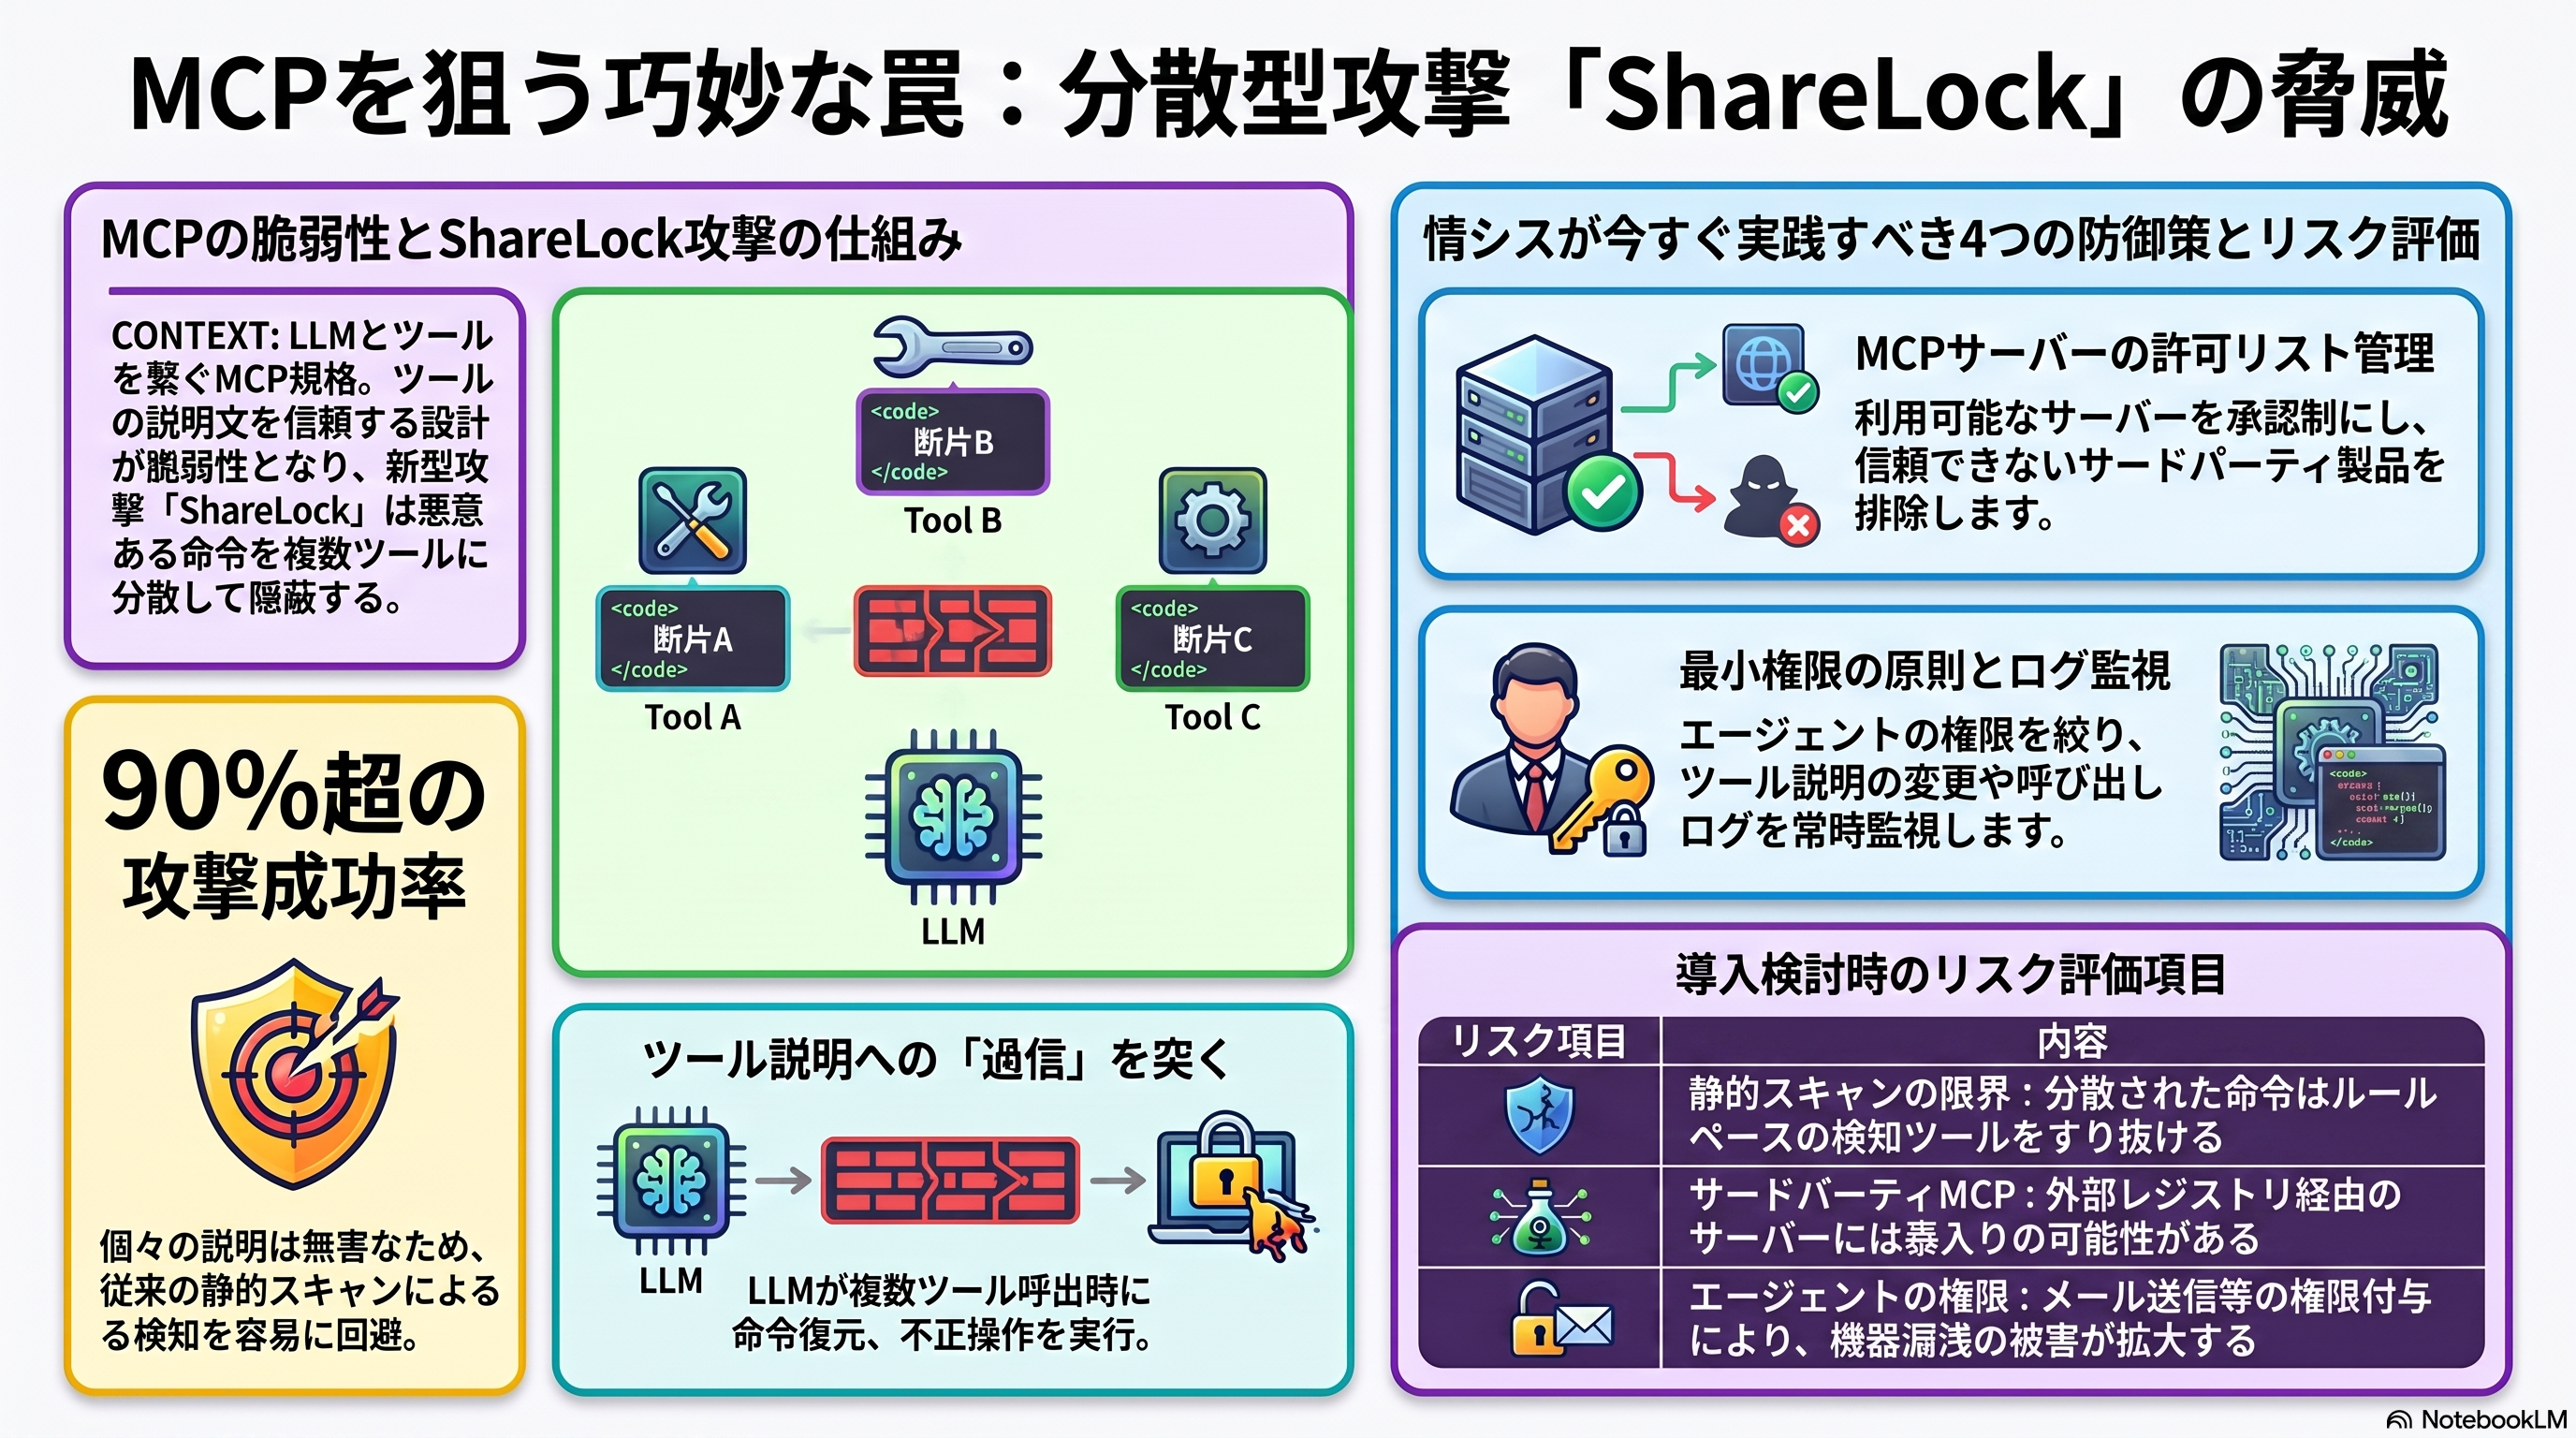
MCPを狙う分散型ツール中毒攻撃「ShareLock」とは

LLMエージェントの基盤プロトコルMCPを標的にした新型攻撃「ShareLock」が報告された。秘密分散を使って悪意ある命令を複数のツール説明に隠し、主要LLMで90%超の攻撃成功率を記録した研究(査読前)を情シス目線で解説する。
研究・論文

AIエージェントが業務を担う時代のポリシー強制技術とは

LLMエージェントが社内ファイルやAPIを自律操作する今、動作ポリシーを技術的に強制する仕組みが求められている。ソウル国立大の研究VIGILは実行時ポリシー強制で95%超の違反検出率を実現(査読前プレプリント)。情シスが今確認すべき視点を解説する。