プロンプトインジェクション

研究・論文

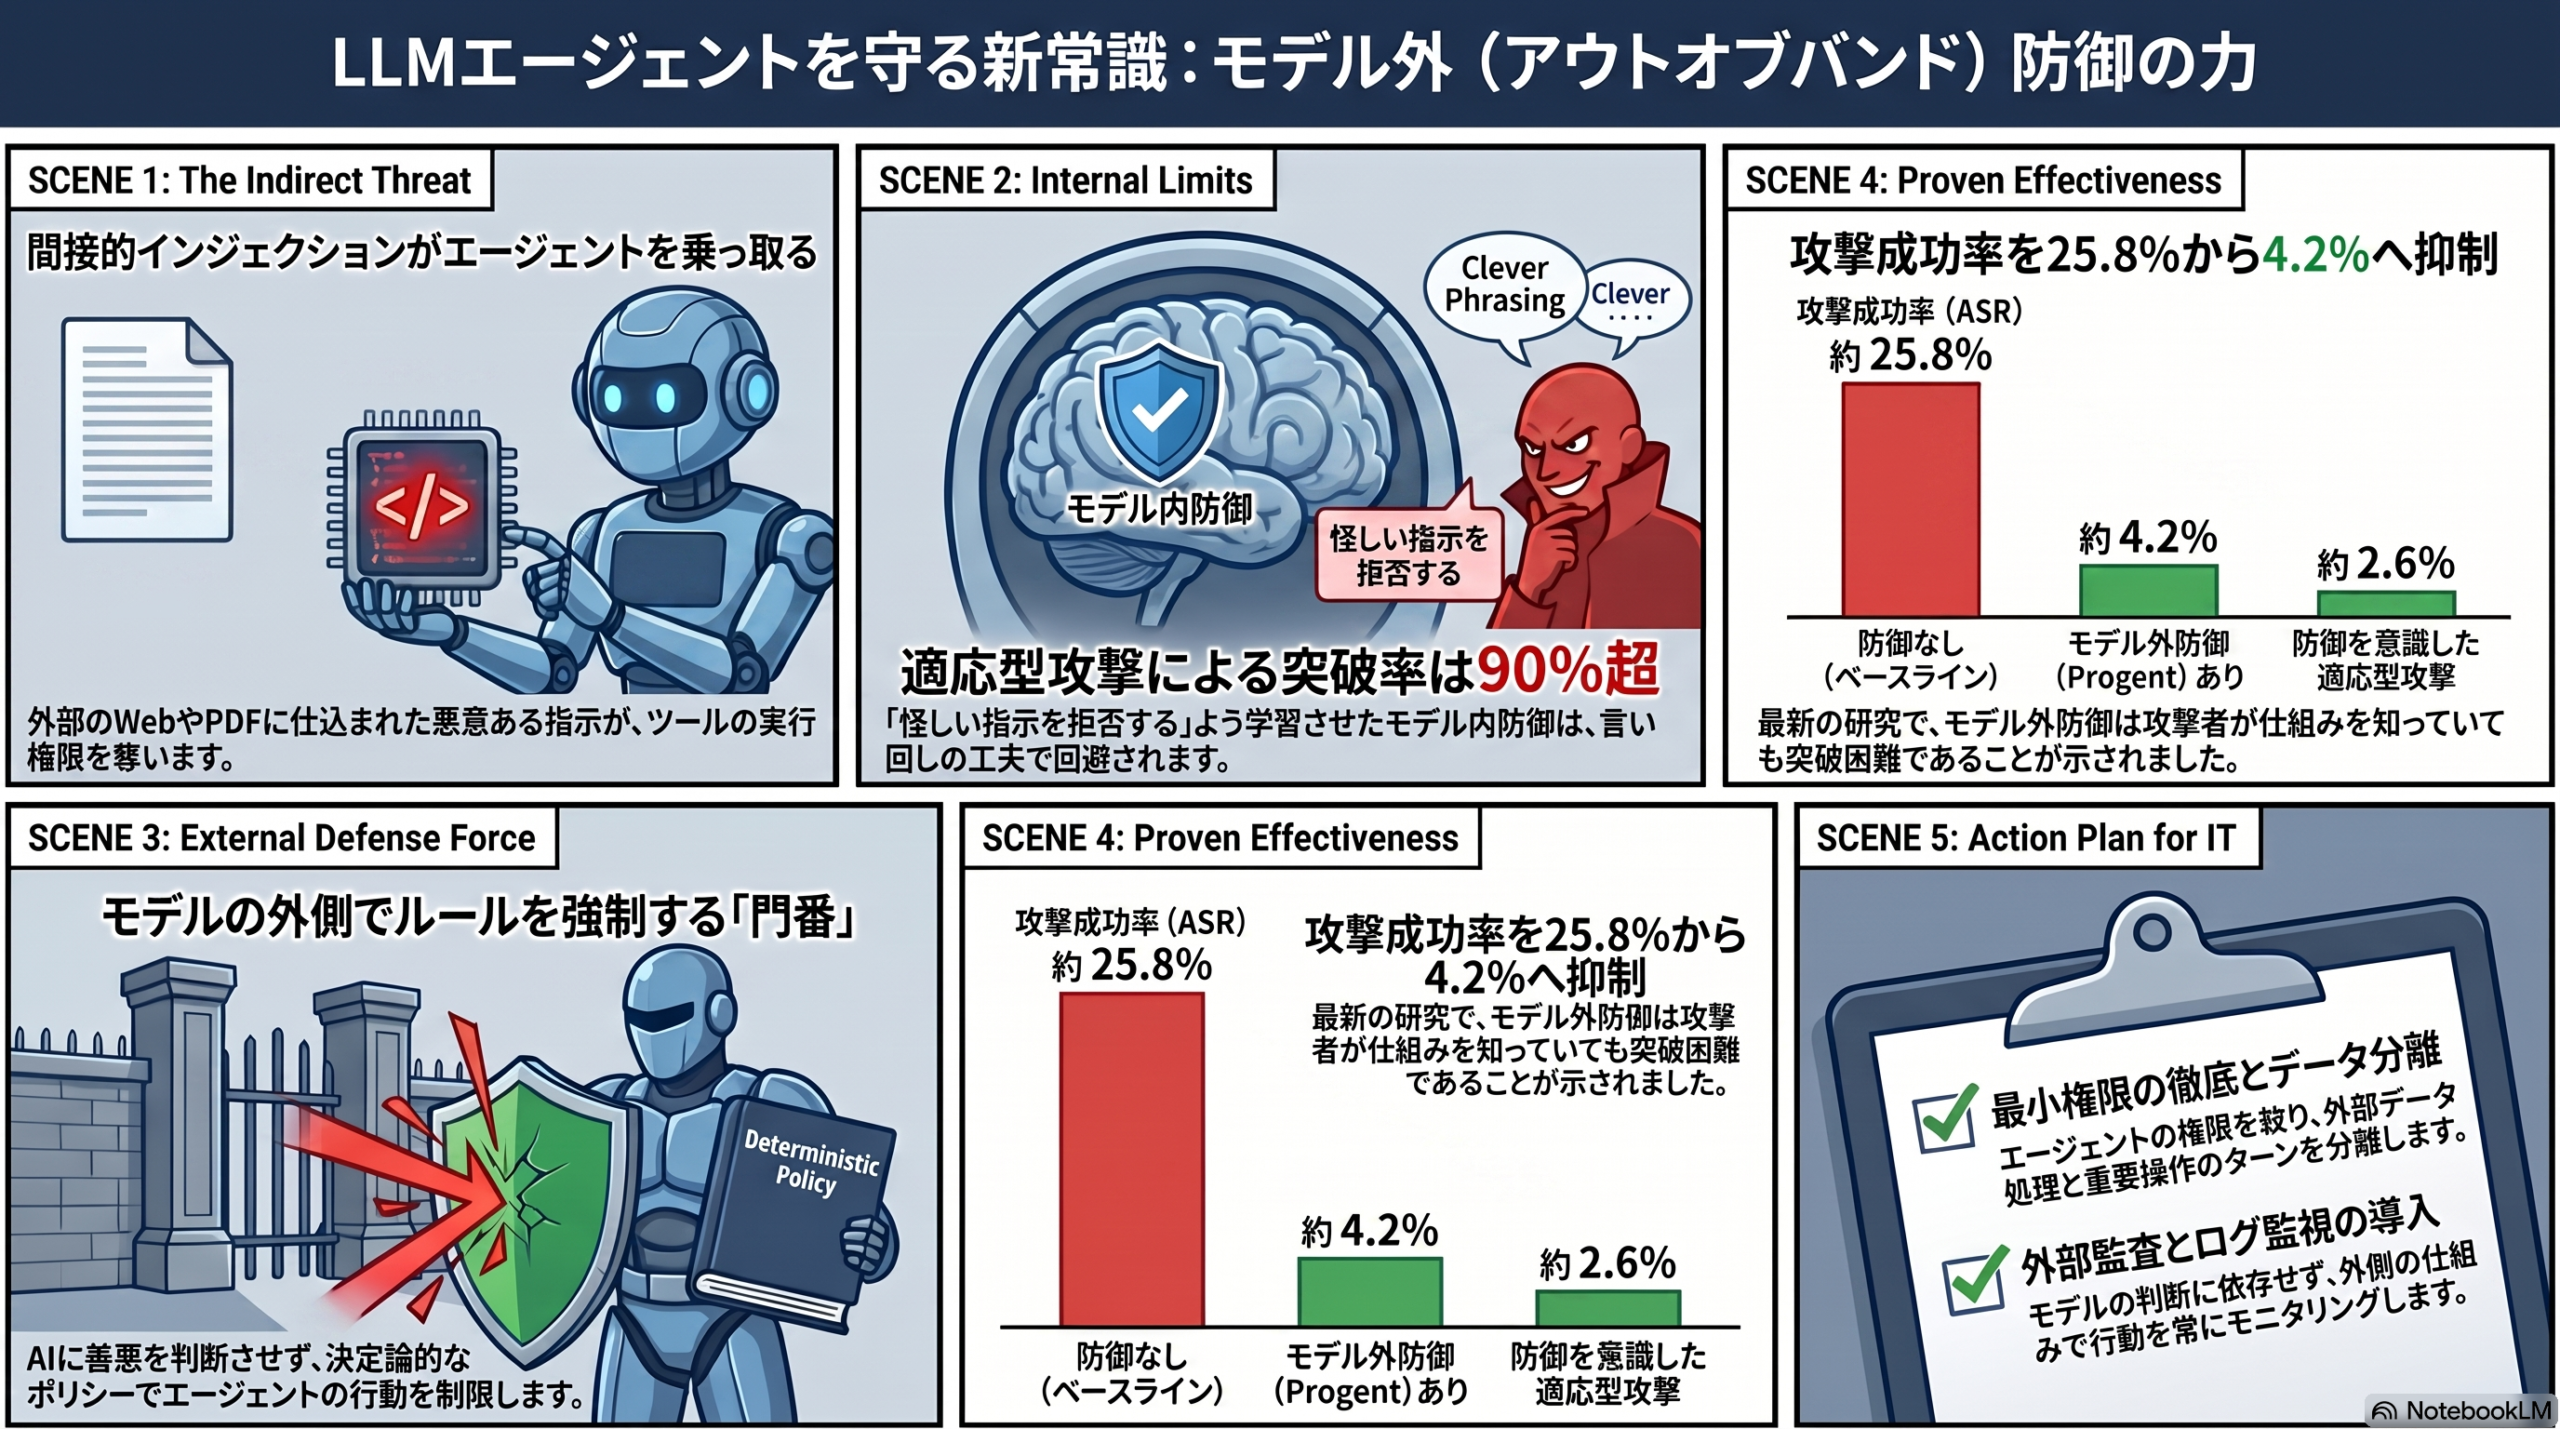
プロンプトインジェクション対策、モデル外防御の実力とは

LLMエージェントへのプロンプトインジェクション対策として注目される「モデル外(アウトオブバンド)防御」を、攻撃者目線で検証した査読前論文を実務者向けに解説。何が分かり、情シスは何に注意すべきかを整理します。
研究・論文
マルチエージェントAIをどう守るか リスク評価と防御強化

複数のAIエージェントが連携するマルチエージェント/GISシステムのセキュリティを扱う査読前研究を解説。攻撃者役LLMによるレッドチーミングとプロンプト強化で、機能を保ったまま堅牢化する手法と、情シスがエージェンティックAI導入時に押さえる勘所を整理します。
研究・論文

AIエージェント型ブラウザに潜む同一オリジンの死角

AIが自律操作するエージェント型ブラウザでは、間接的プロンプトインジェクションと組み合わさり同一オリジンポリシーが実質無力化されうる──そう警鐘を鳴らす査読前研究を、情シス目線で解説します。
研究・論文

AIコードレビューは騙せるか─悪意あるPR承認の研究

LLMによるコードレビューは、巧妙な「言い回し」で悪意あるプルリクを承認してしまうのか。1,062件の悪性PRと15種の社会工学的フレーミングで8つのLLMを評価した査読前研究を、情シス視点で読み解きます。