RAG

研究・論文

インシデント初動1時間にAIは使えるか|査読前研究

インシデント初動の「最初の1時間」でAIはどこまで信頼できるのか。査読前論文はRAGを現実的な中間解としつつ、プロンプト感度と「自信のある幻覚」を重大リスクに挙げます。情シスがAIに任せてよい範囲の線引きを解説します。
脆弱性・脅威情報

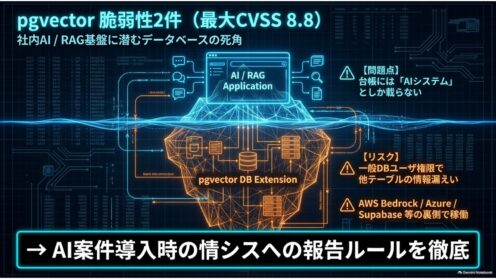
pgvector脆弱性2件、社内RAG基盤の点検ポイント

PostgreSQLのベクトル検索拡張pgvectorに脆弱性2件(CVE-2026-3172/CVE-2026-18022)。社内RAG基盤の裏側で動いていることが多く、資産台帳では気づけません。確認SQLと点検の勘所を解説します。
研究・論文

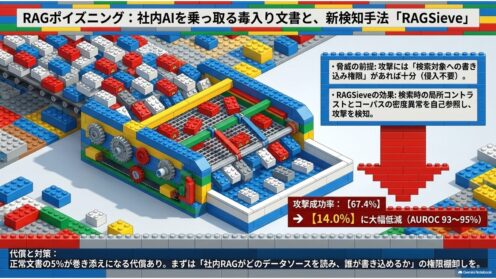
RAGポイズニング検知|攻撃成功67%を14%へ

社内RAGに毒入り文書を混ぜる攻撃を、正解データなしで検知する手法RAGSieveの査読前研究を解説。攻撃成功率67.4%→14.0%という実測値の読み方と、情シスが今日確認すべきインデックスの棚卸しまで。
研究・論文

社内RAGの機密を外部LLMから隠す|研究解説

社内RAGでは、検索でヒットした社内文書と質問文が外部LLM事業者にそのまま渡ります。機密を自然な別名に置き換えて隠す査読前の新研究SEAGについて、秘匿率85〜90%という実測値の読み方と、長文・日本語が未検証という限界を情シス向けに解説します。
研究・論文

AIエージェントのメモリ干渉|記憶が更新されない罠

AIエージェントの長期記憶は、新しい情報を入れても上書きされないことがある。arXivの査読前論文が示した「メモリ干渉」の構造と、社内AI運用で情シスが備えるべき点を解説します。
研究・論文

セキュリティ要件の抜けをNLPで検知|研究解説

開発バックログに埋もれたセキュリティ要件をNLPで検知し、社内規程やCIS Benchmarksから該当条項を提示する研究がASE 2026に採録されました。再現率を優先した設計思想と、情シスが導入前に確認すべき前提を実務目線で解説します。
研究・論文

RAGの情報漏えいは質問で変わる|査読前の新研究

社内文書を使うRAGの情報漏えいリスクは「どの文書か」ではなく「どんな質問か」で決まる——2026年7月公開の査読前研究(PA-HDP)を、RAGを導入・検討する情シス向けに噛み砕いて解説します。
研究・論文

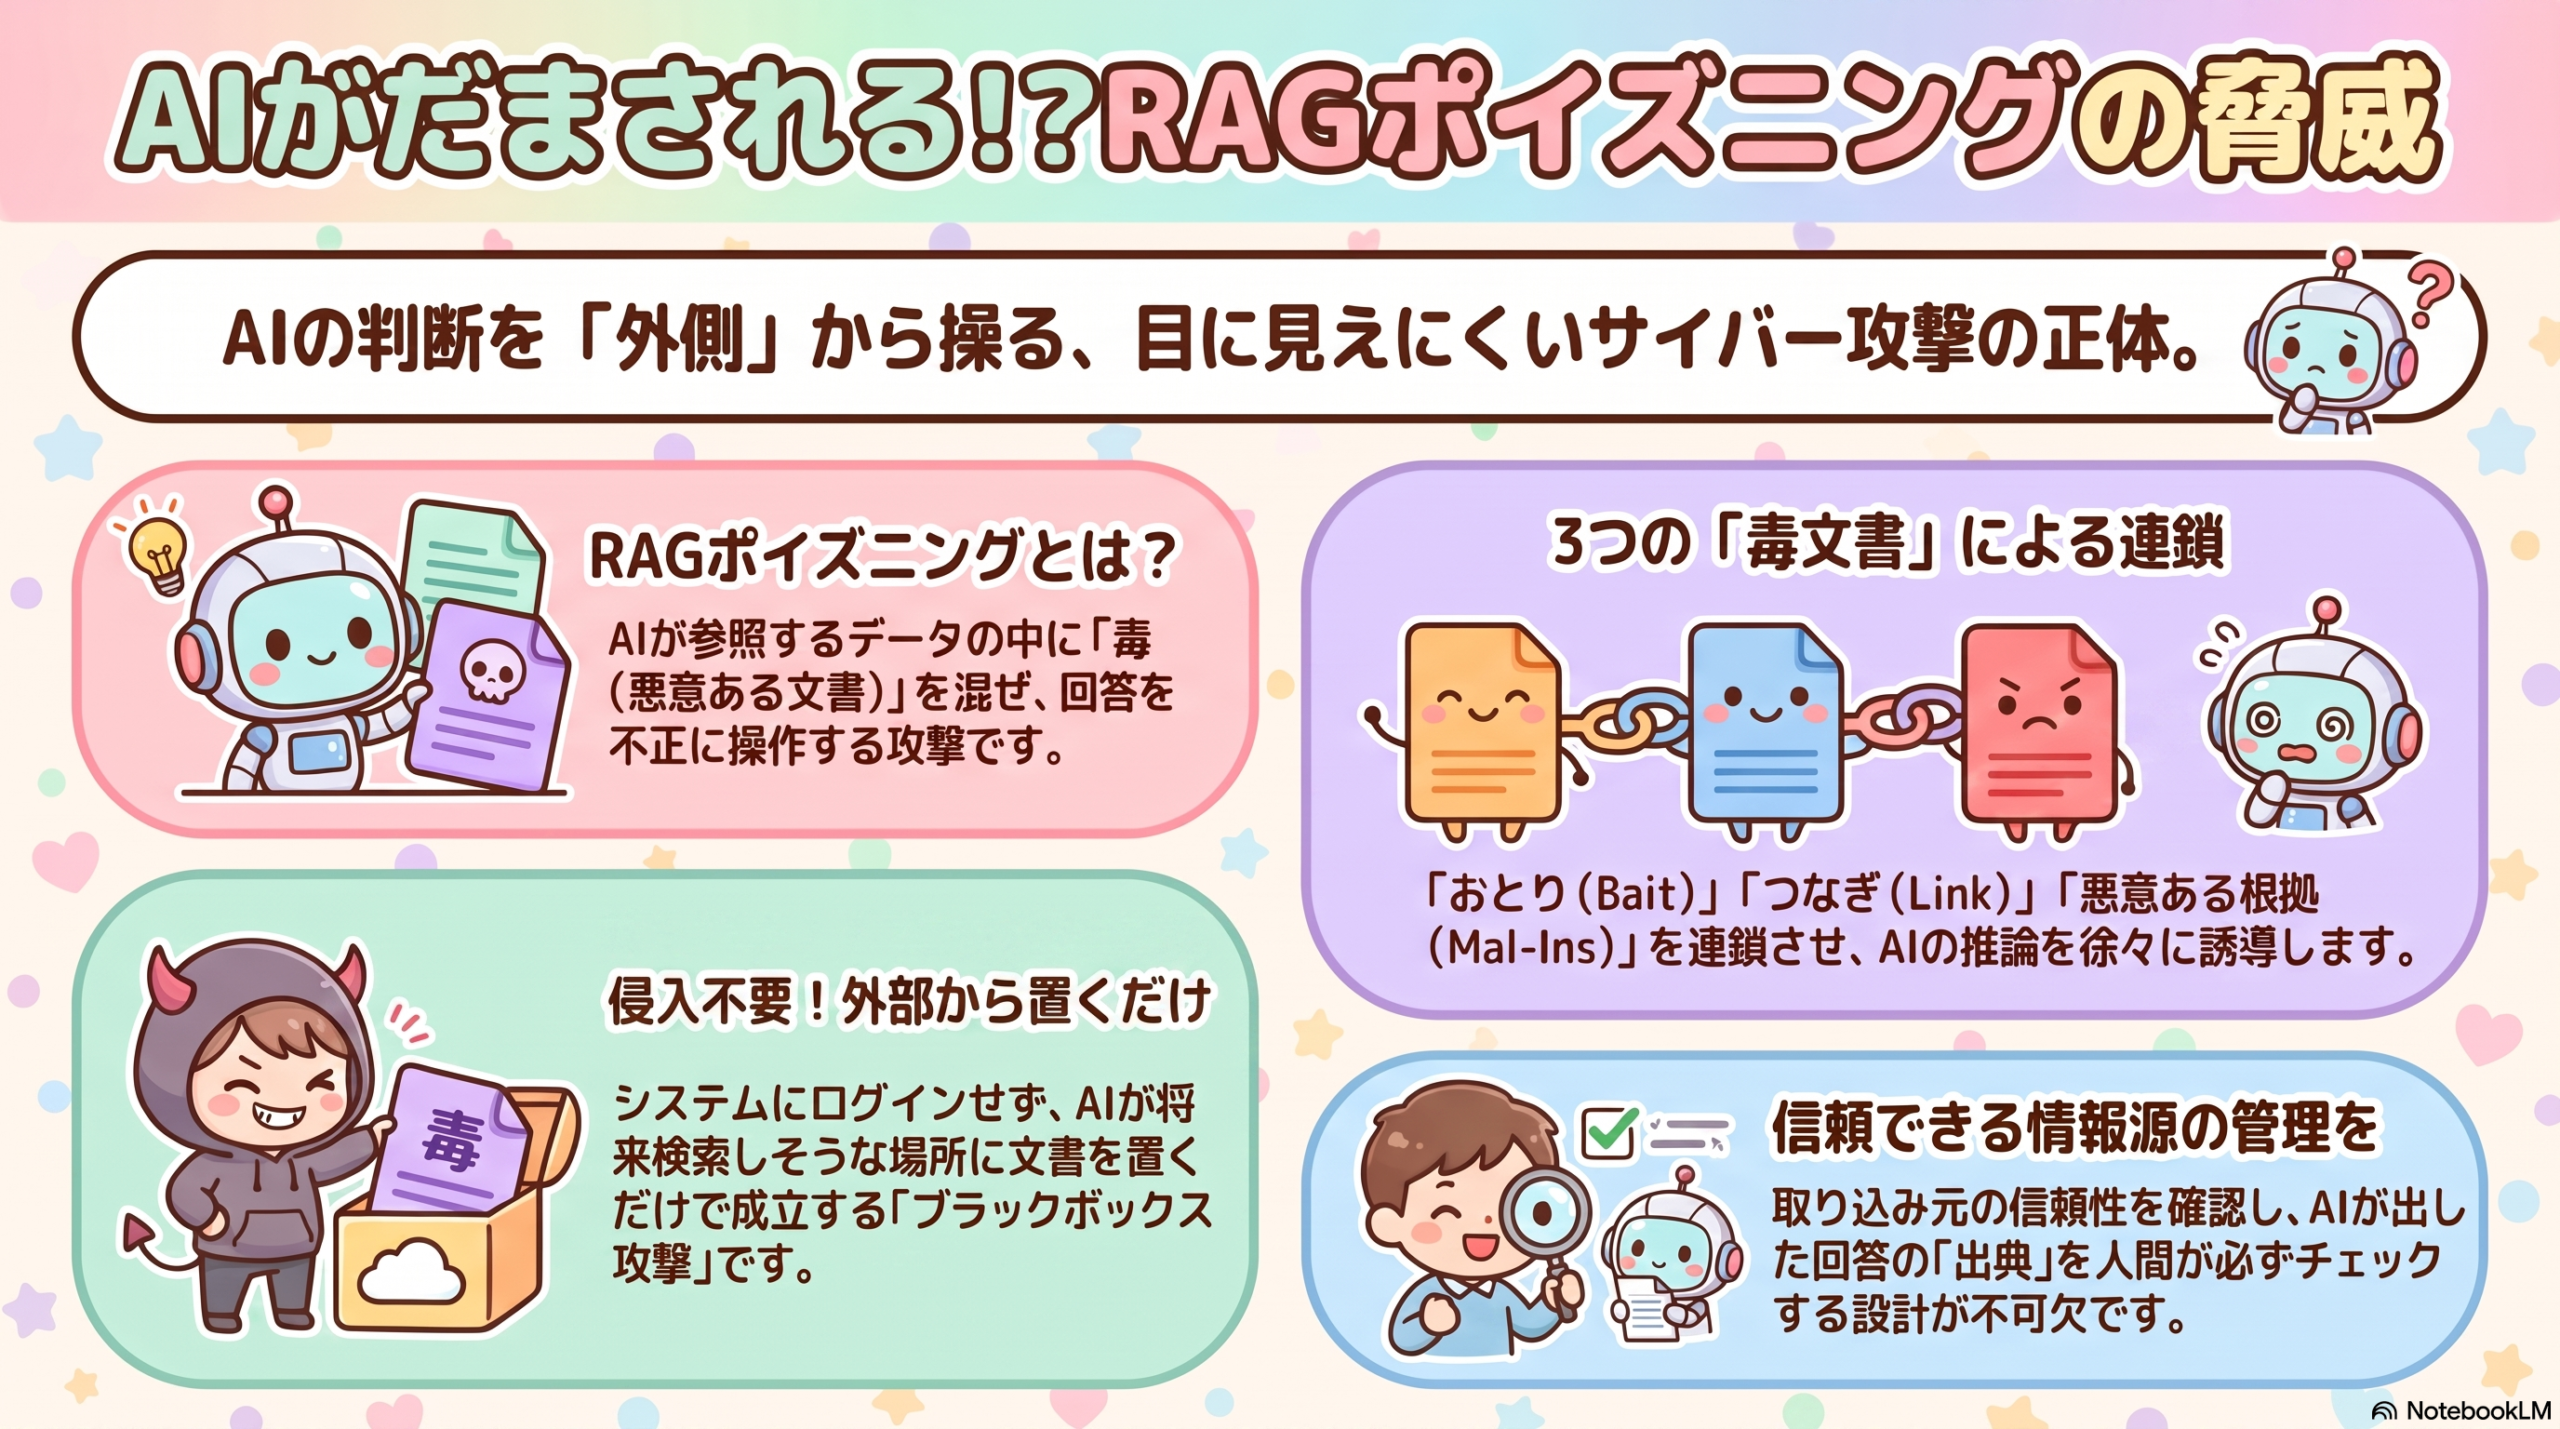
RAGポイズニングとは?AIエージェントを乗っ取る攻撃

社内のAI検索やエージェントで使われるRAGを、外部に置いた文書だけで乗っ取る攻撃手法「KidnapRAG」の査読前研究を、情シス実務者向けに解説します。仕組み・実務への影響・今すぐ押さえるべき公的指針をまとめました。
研究・論文

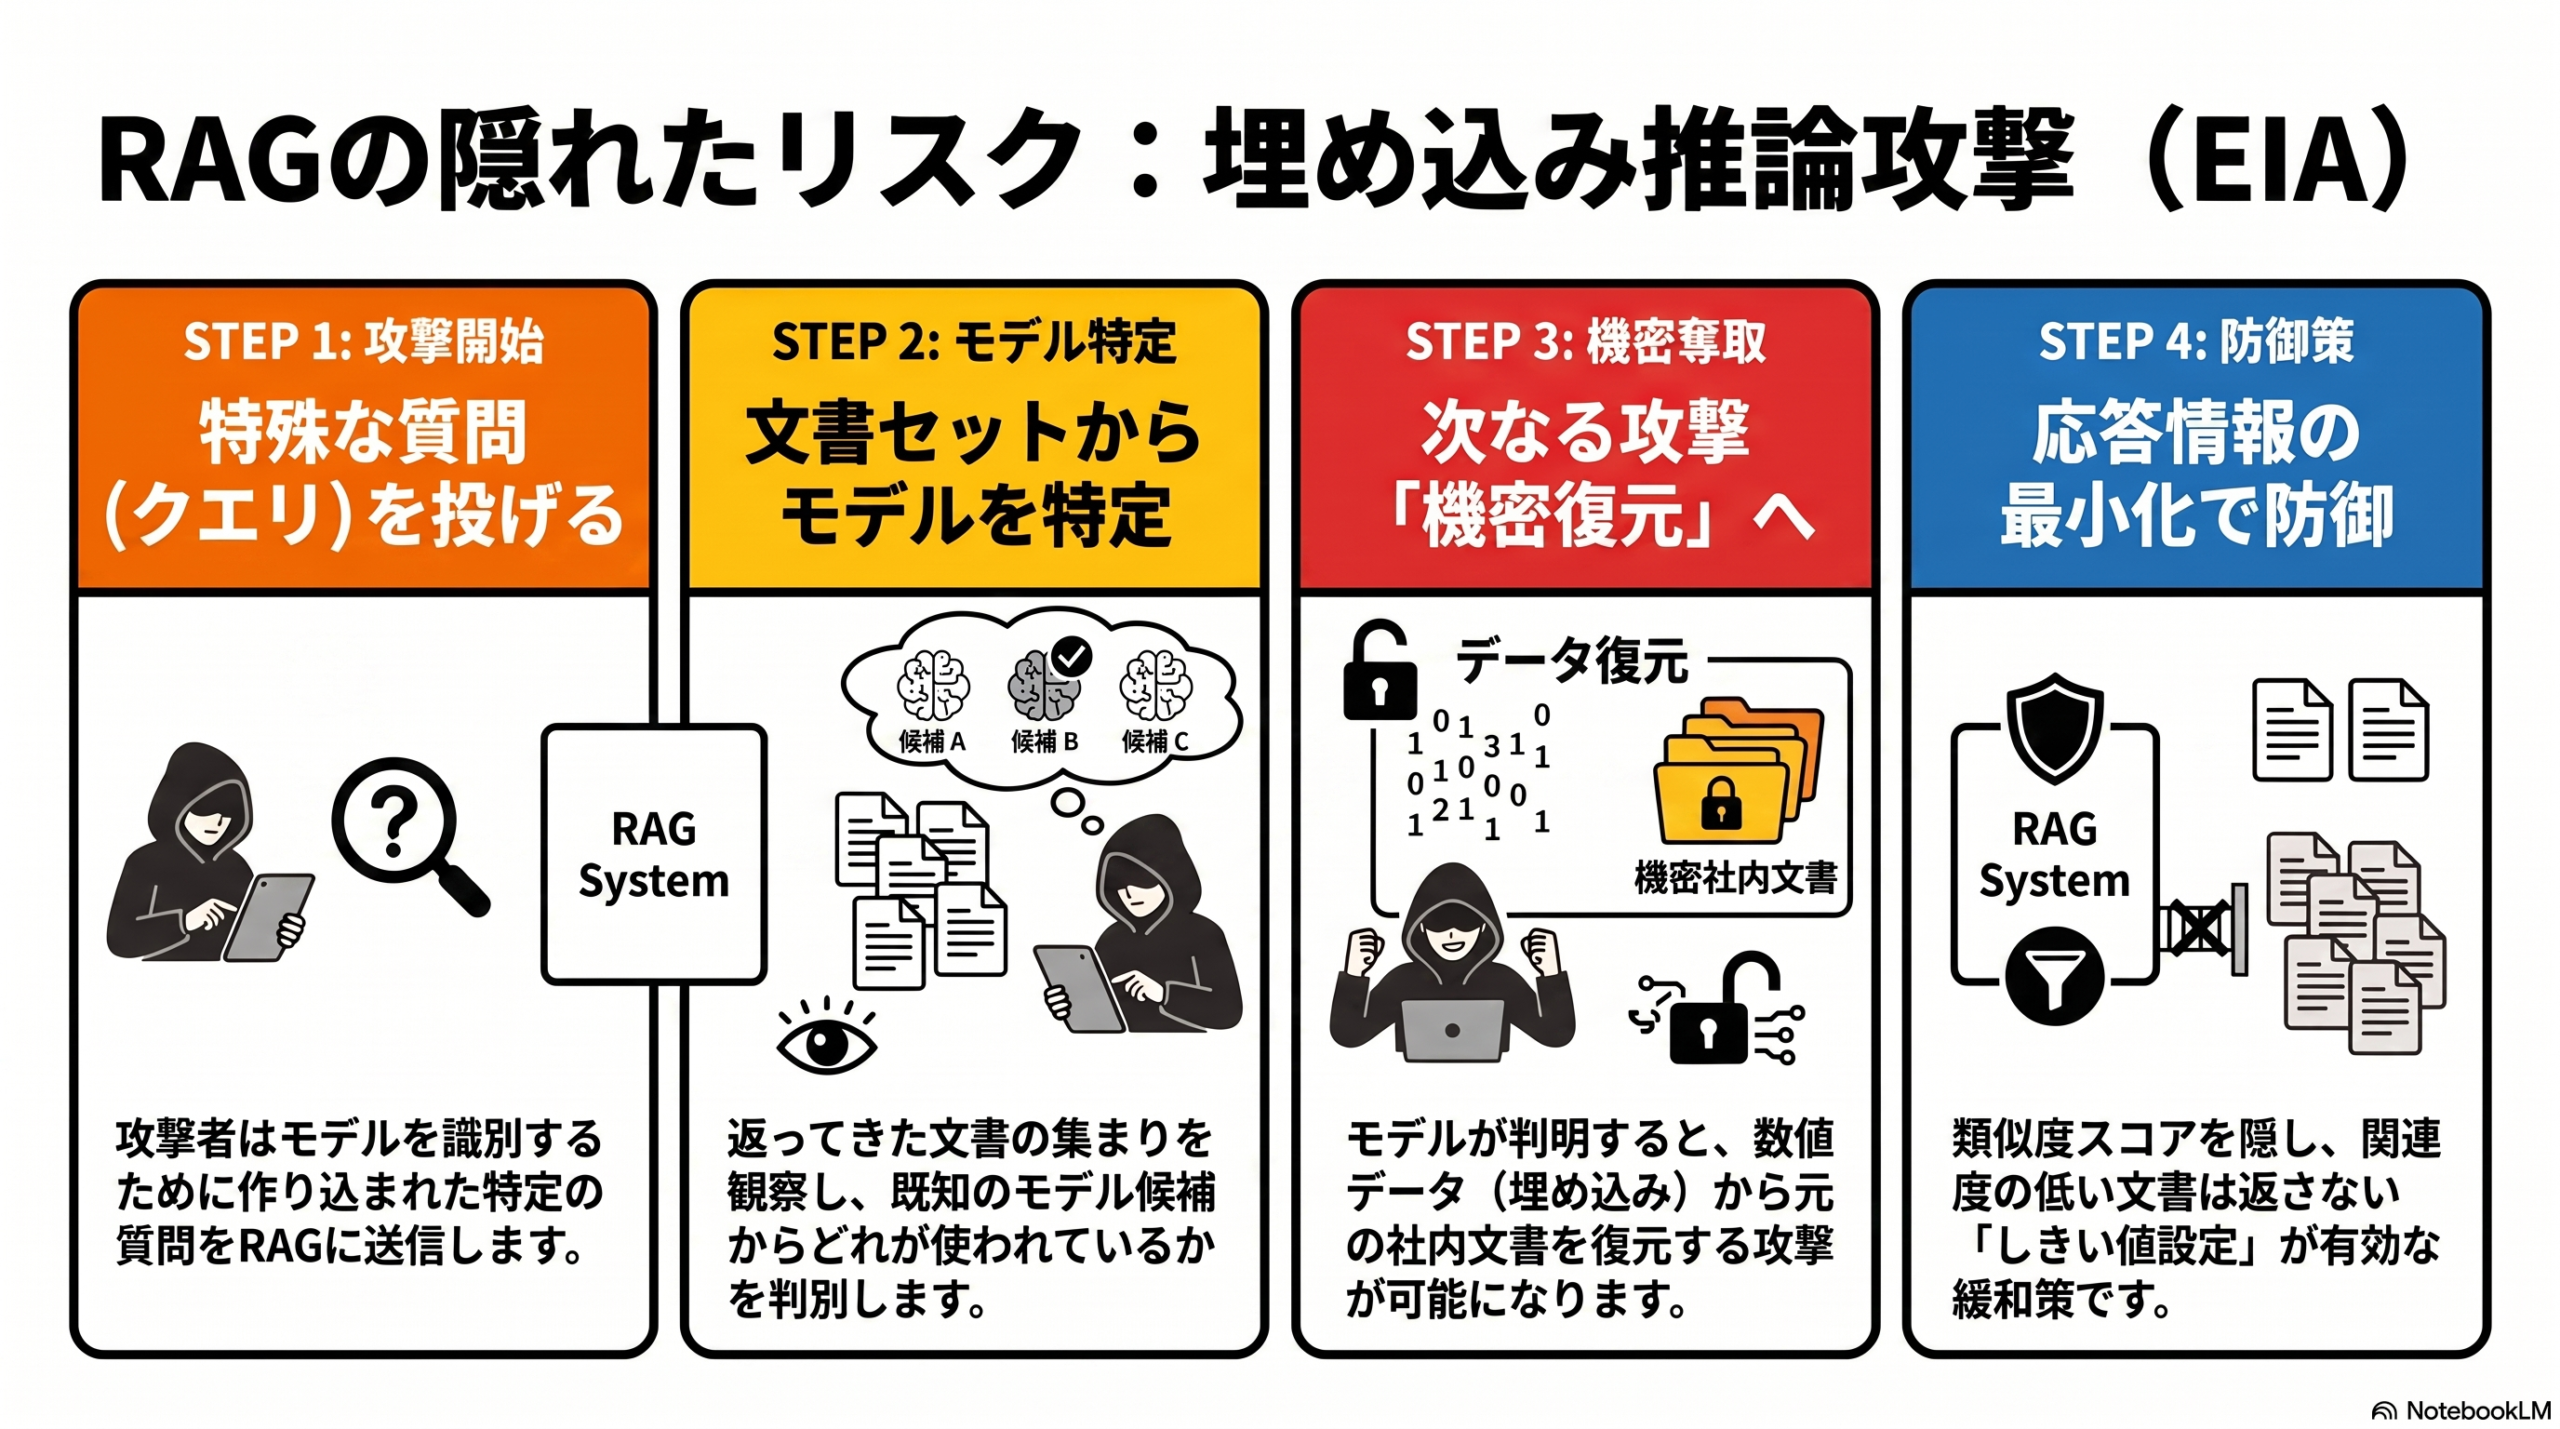
RAGを狙う「埋め込み推論攻撃」とは―査読前研究

社内RAGの「埋め込みモデル」が、返ってくる文書を観察するだけで外部から特定される――そんな攻撃手法を示した査読前研究を、情シス実務者向けに噛み砕いて解説します。偵察リスクとしての意味と、現実的な緩和策を整理しました。
研究・論文

LLMエージェントが「知りすぎる」問題:プライバシー漏洩の経路と対策

LLMエージェントは業務効率化の強力なツールだが、クエリ・メモリ・ツール呼び出しなど5つの経路から機密データが漏洩しうる。情シス担当者が把握すべきリスクの全体像と対策の方向性を解説。