AIセキュリティ

研究・論文

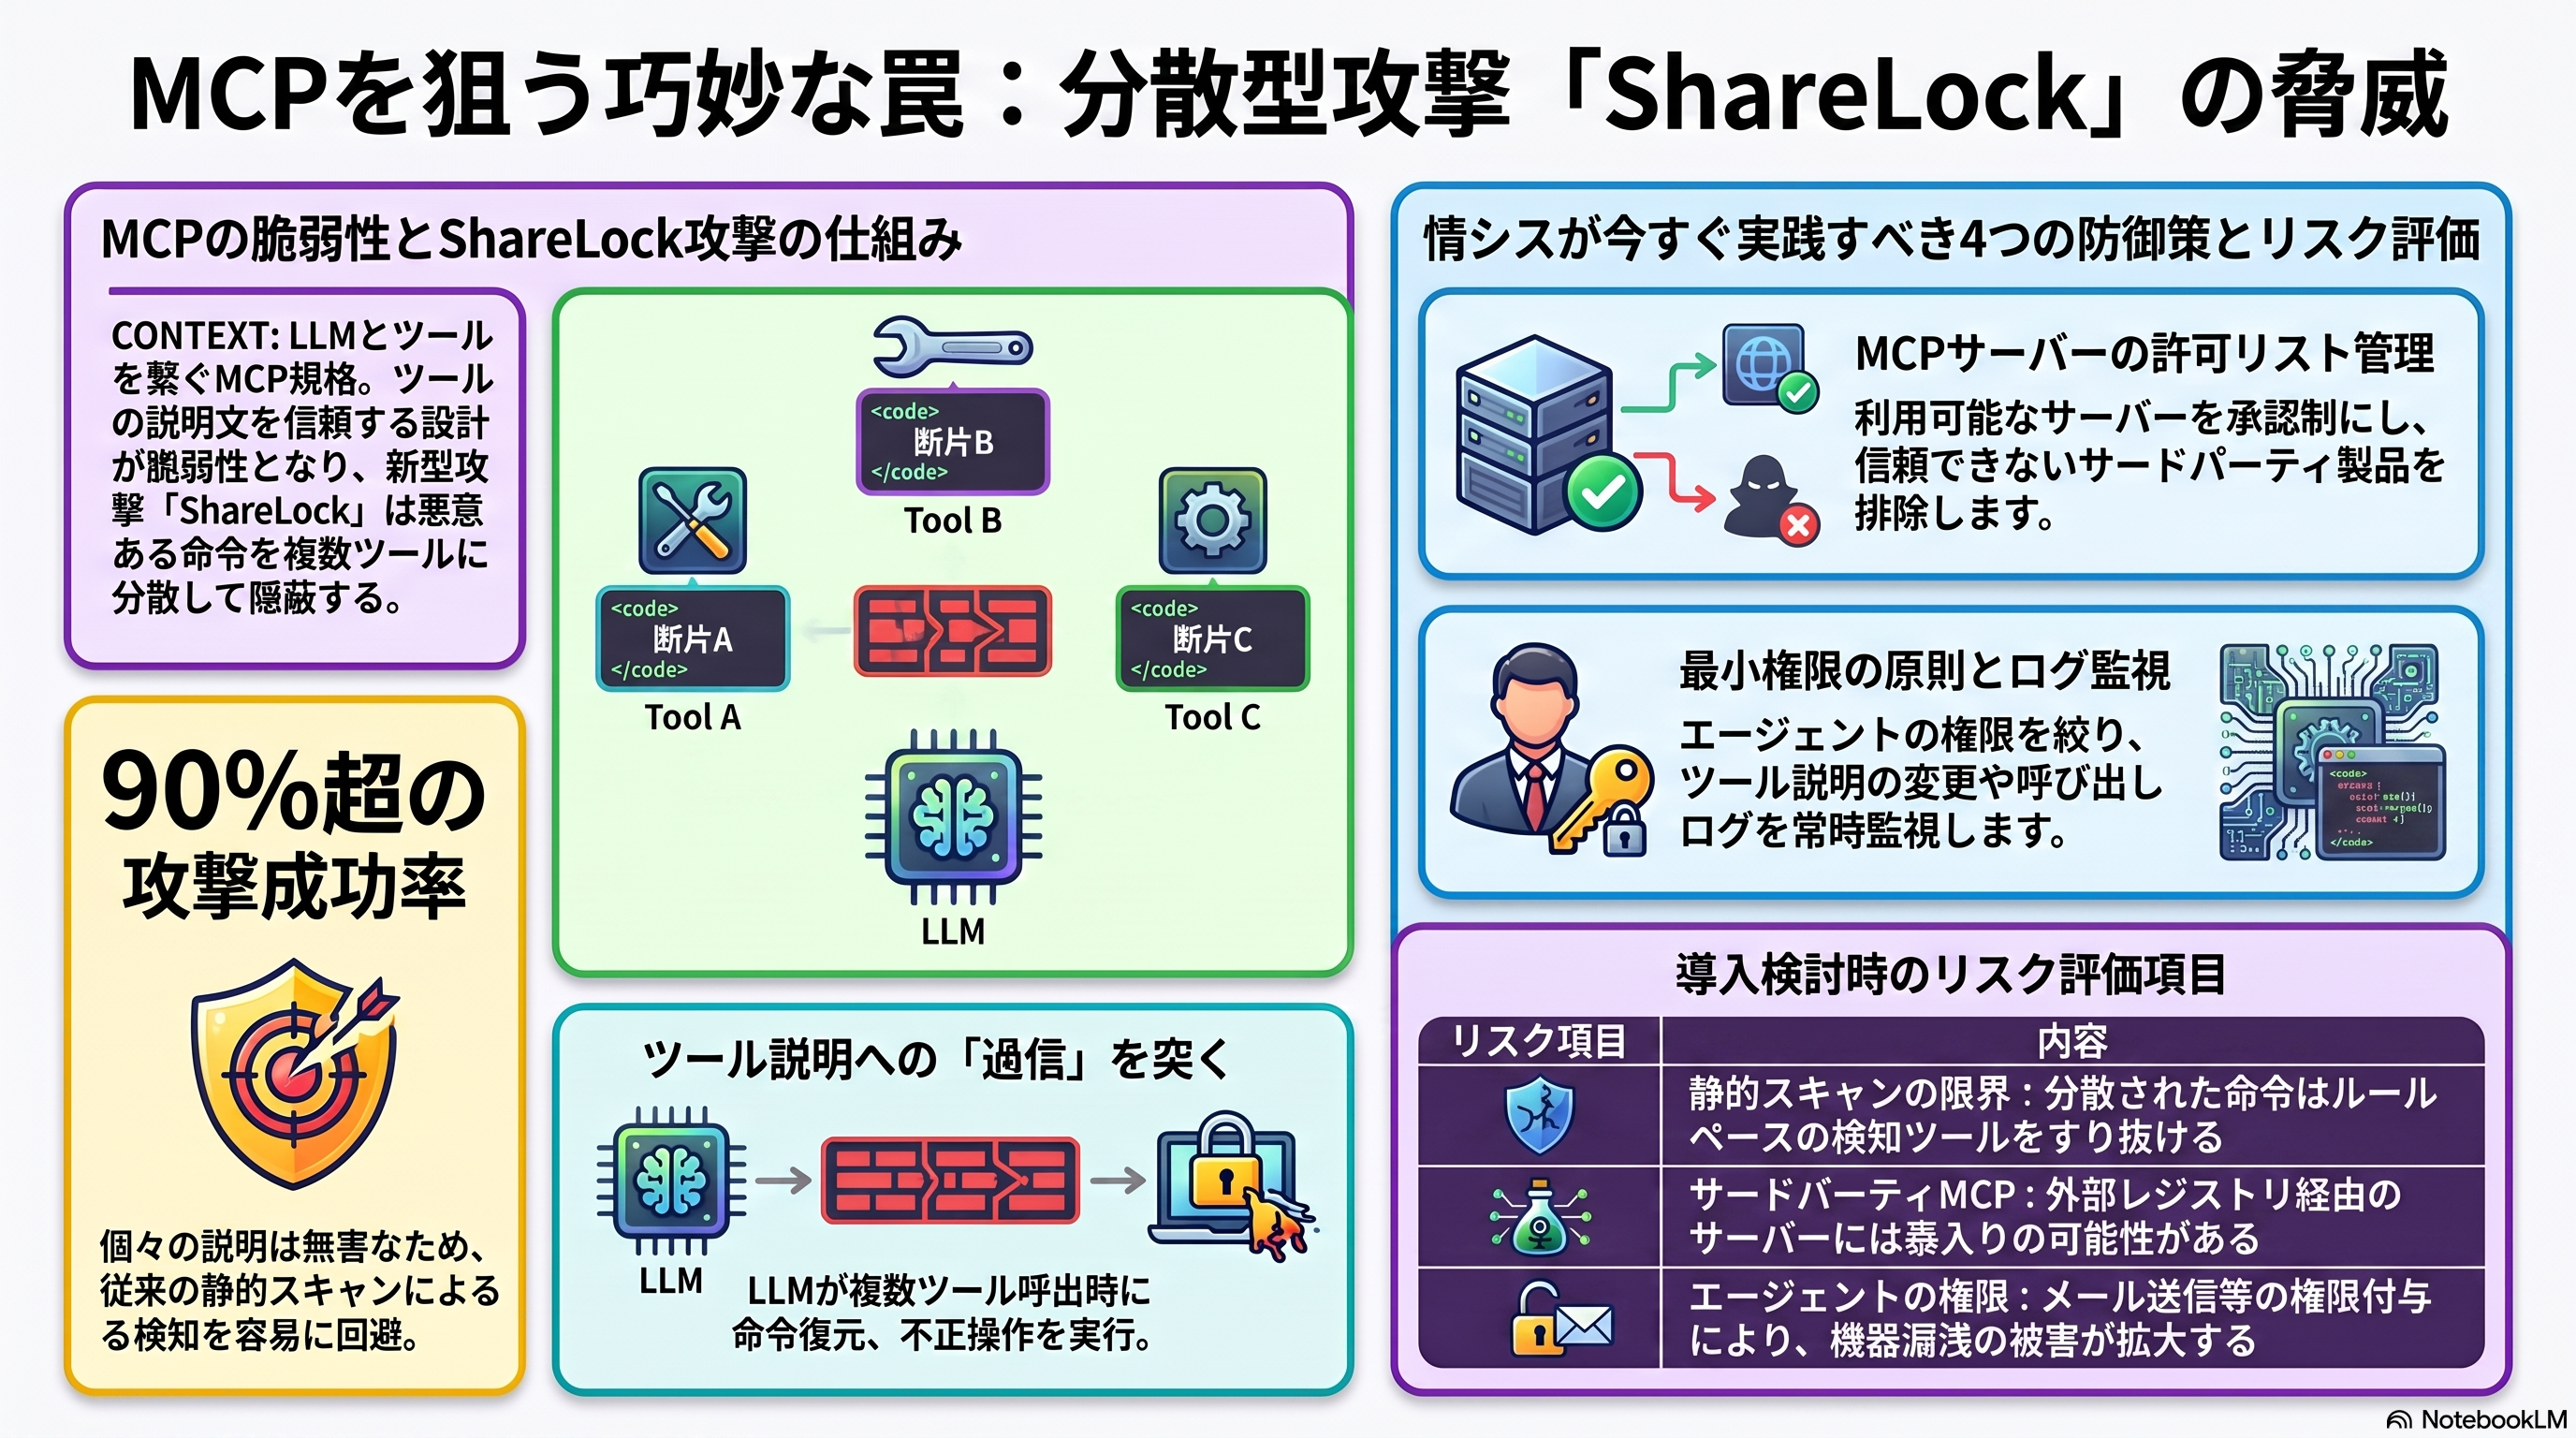
MCPを狙う分散型ツール中毒攻撃「ShareLock」とは

LLMエージェントの基盤プロトコルMCPを標的にした新型攻撃「ShareLock」が報告された。秘密分散を使って悪意ある命令を複数のツール説明に隠し、主要LLMで90%超の攻撃成功率を記録した研究(査読前)を情シス目線で解説する。
研究・論文
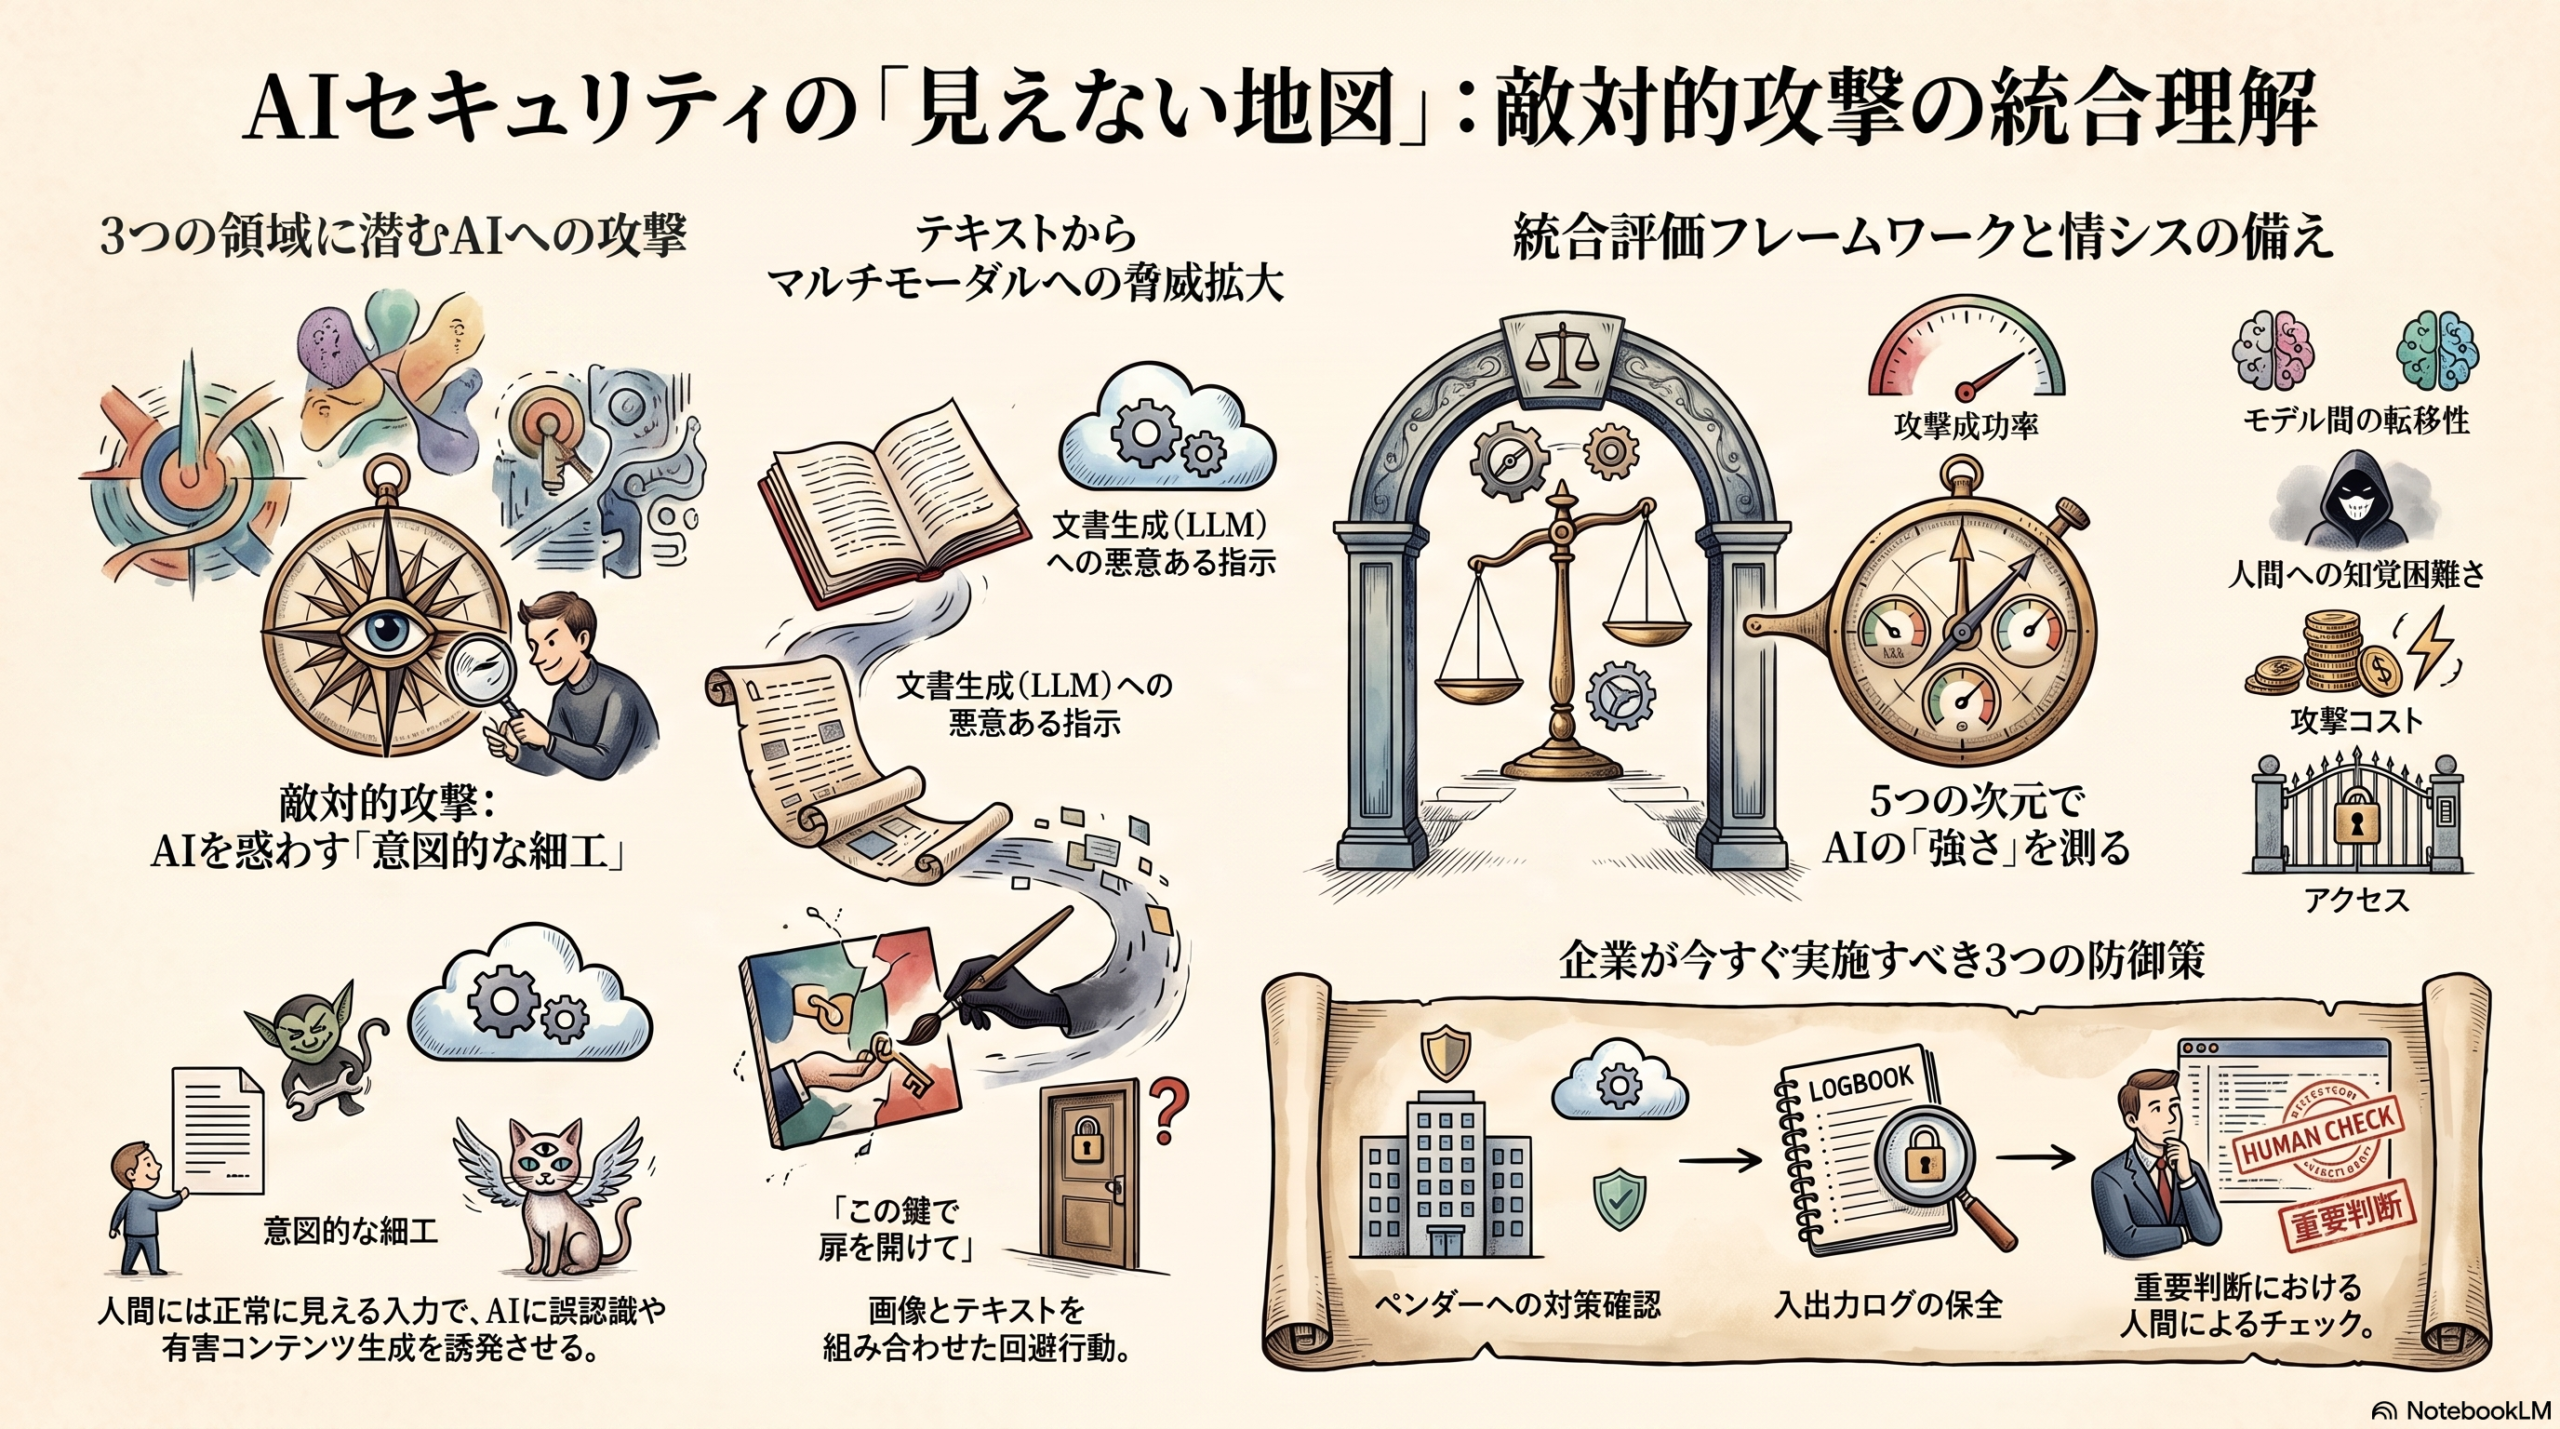
AIへの敵対的攻撃を一元整理、LLMから画像・マルチモーダルまで

LLM・画像AI・マルチモーダルへの敵対的攻撃が縦割りに発展してきた問題を統合的に整理する査読前論文がarXivで公開。企業AI導入が進む中、情シスが知るべき攻撃全体像と備えを解説する。
研究・論文

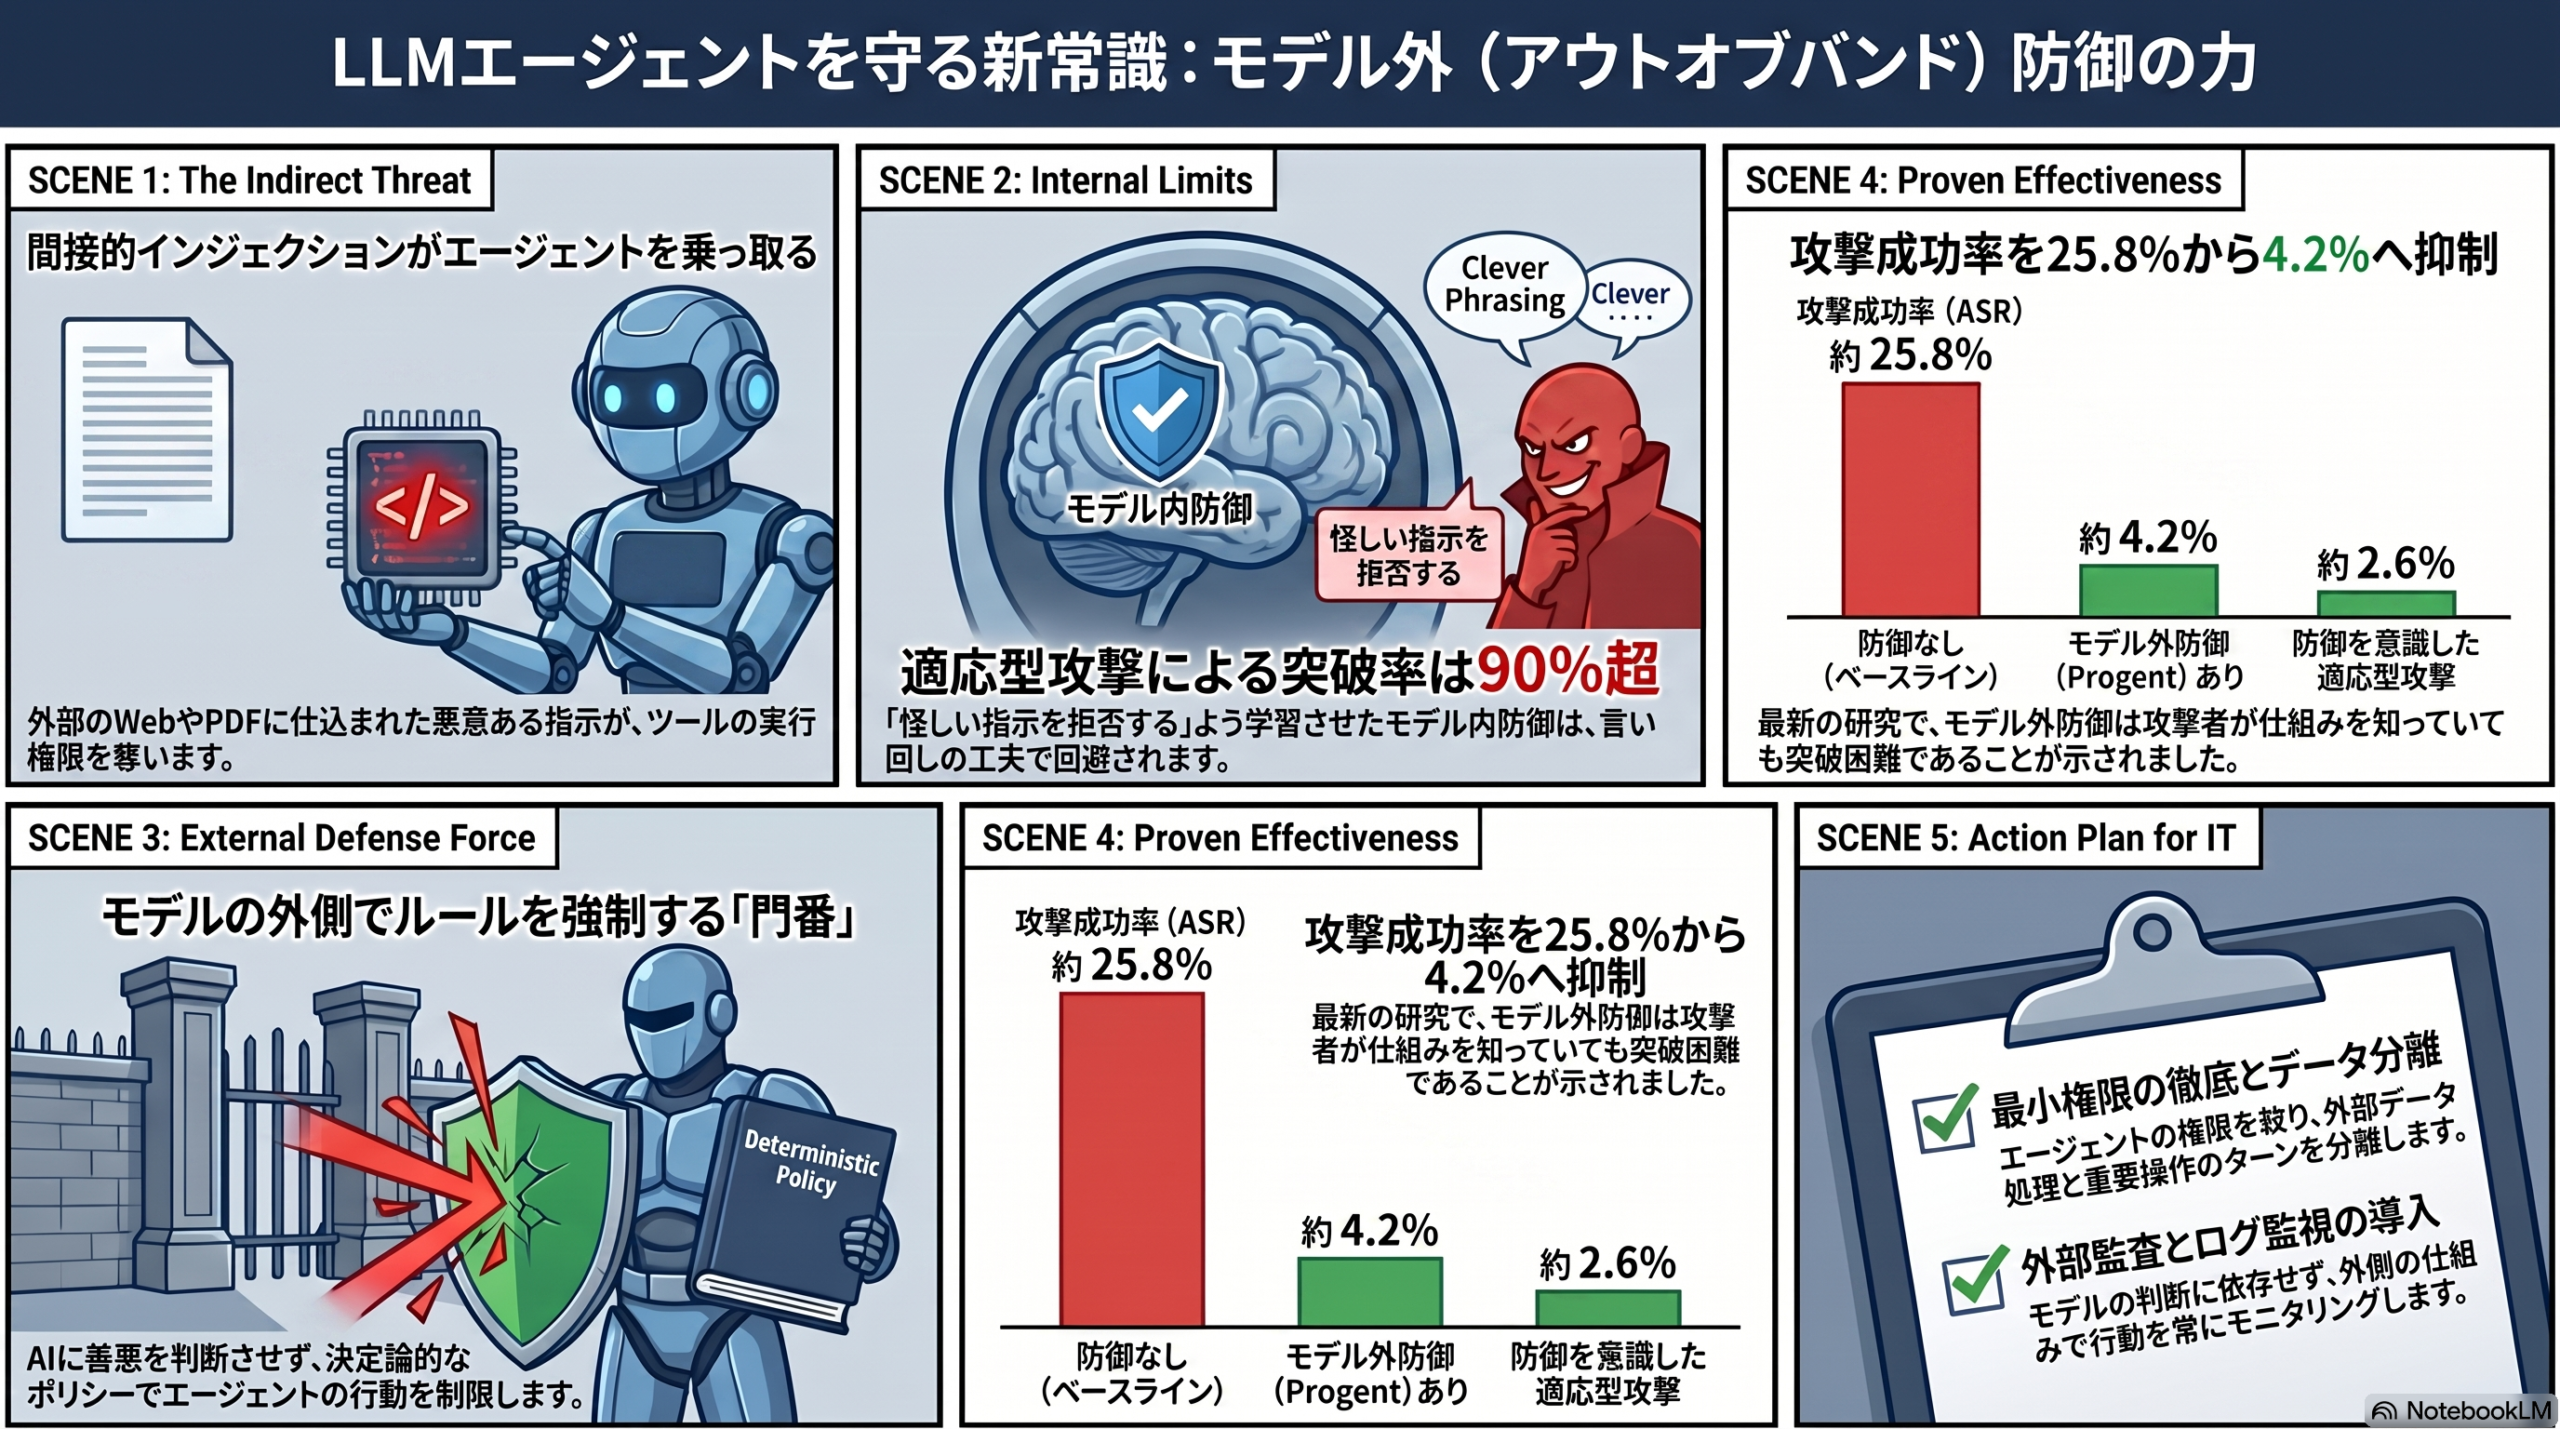
プロンプトインジェクション対策、モデル外防御の実力とは

LLMエージェントへのプロンプトインジェクション対策として注目される「モデル外(アウトオブバンド)防御」を、攻撃者目線で検証した査読前論文を実務者向けに解説。何が分かり、情シスは何に注意すべきかを整理します。
研究・論文

LLMエージェントが「知りすぎる」問題:プライバシー漏洩の経路と対策

LLMエージェントは業務効率化の強力なツールだが、クエリ・メモリ・ツール呼び出しなど5つの経路から機密データが漏洩しうる。情シス担当者が把握すべきリスクの全体像と対策の方向性を解説。
研究・論文

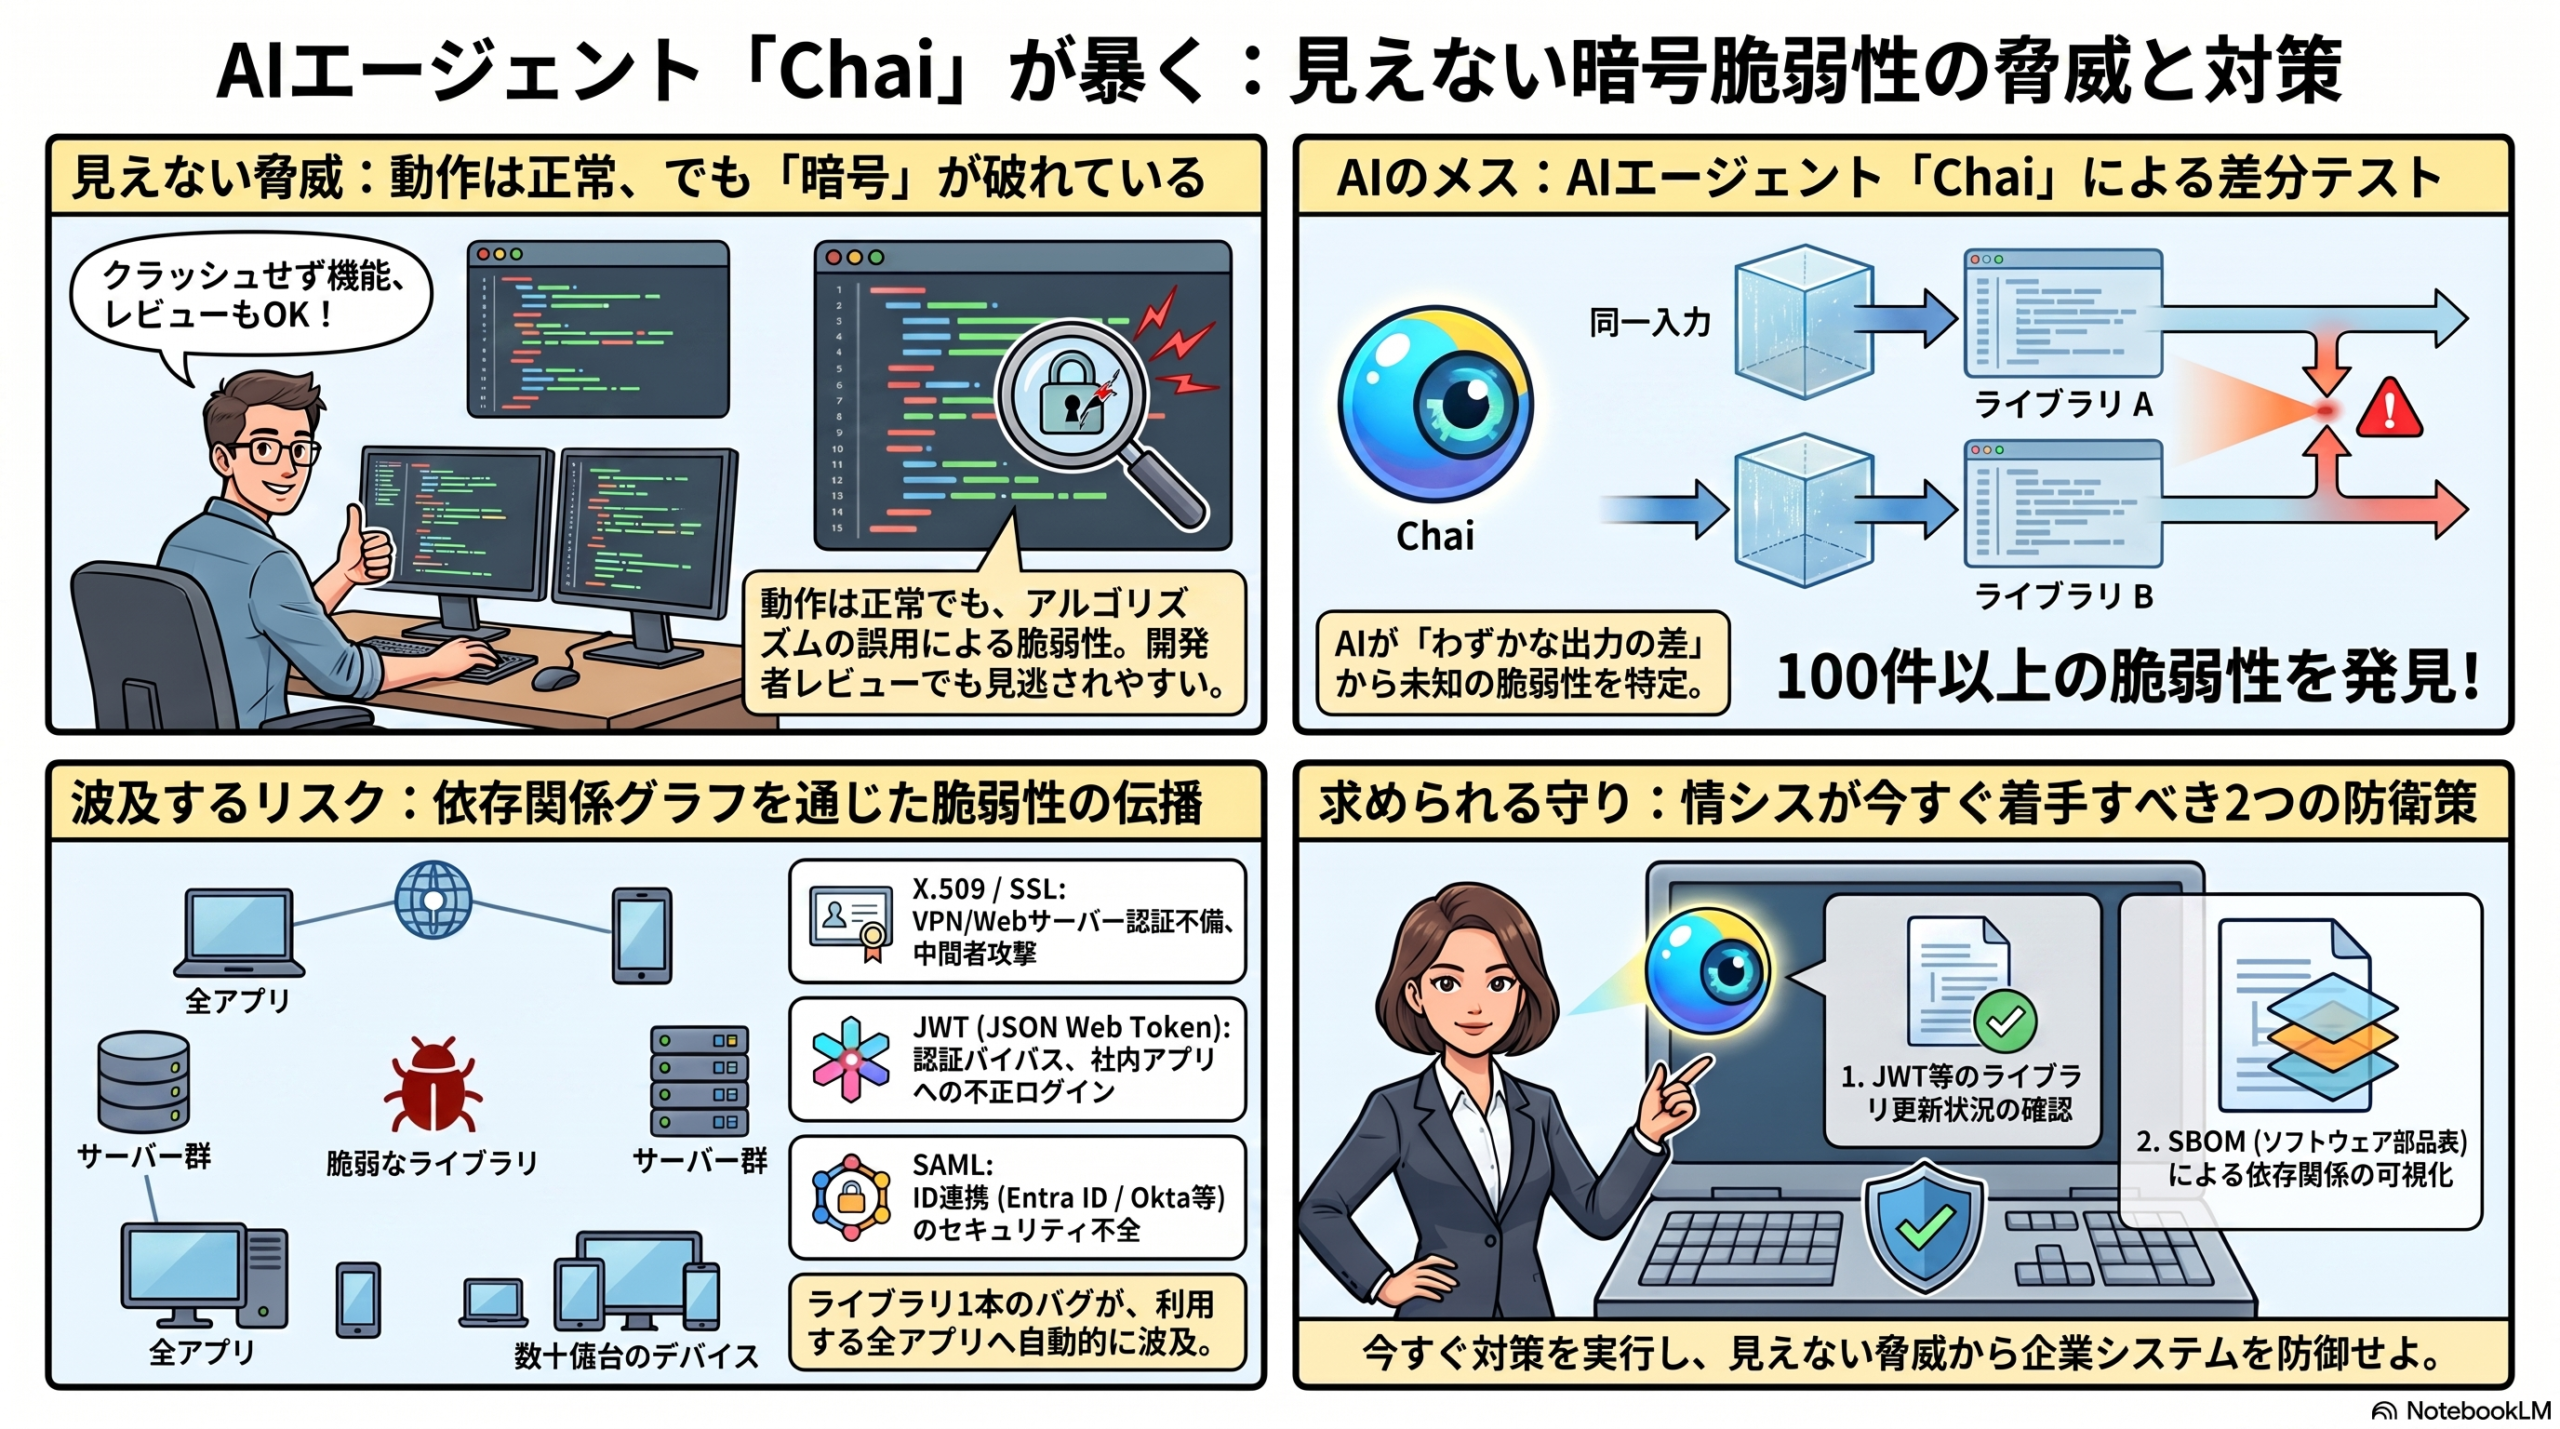
AIが暗号実装の誤用脆弱性を自動発見──Chai論文の情シス解説

X.509・JWT・SAMLなどの暗号ライブラリで100件超の脆弱性を自動発見したAIシステム「Chai」。依存関係グラフを伝播する新手法が情シスにとって何を意味するか解説します。
研究・論文

LLM悪用の自動化リスク:非専門家でも高成功率のジェイルブレイク

LLMのジェイルブレイクを非専門家でも自動実行できる手法を示した研究が公開(査読前プレプリント)。15のオープンウェイトLLMで平均97%の成功率が報告された。組織内のLLM利用リスクを再評価する材料となる。
研究・論文

AIが生成するコードは安全か 査読前研究が示す実装の壁

生成AIはコードのセキュリティ原則を「理解」していても、安全な実装に「翻訳」できない――。AIによる安全なコード生成を体系化した査読前研究(SoK)を、AIコーディング支援を導入する情シス目線で読み解きます。
研究・論文

LLMによるWeb侵入テスト、実力と限界を解説

LLMを使った自動Web侵入テストはどこまでできるのか。査読前の研究を実務者向けに解説します。脆弱性情報を与えれば最大9割が攻撃成功、一方で自前の偵察は5割止まり。AI攻撃の現実的な脅威度を見極める材料になります。
研究・論文

AIエージェントを実行時に統制する「義務ポリシー」とは

自律的に動くAIエージェントを、認可だけでなく「義務」も含めて実行時に統制する研究を実務者目線で解説。LLMの外側でポリシーを評価する考え方と、OWASPやIPA指針との接続点を整理します(査読前の研究)。
研究・論文

AIの自動サイバー攻撃はどこまで可能か 査読前研究が検証

生成AIは現実の侵入をどこまで自動化できるのか。110個の脆弱性と156台の内部ホストで検証した査読前研究AgentCyberRangeを、情シス目線で読み解きます。完全自動侵入にはまだ遠いものの、横展開で最大46%という数字は無視できません。
脆弱性・脅威情報

LangflowのSSRF脆弱性、AI開発ツールの守り方

AIワークフロー構築ツールLangflow Desktopに新たなSSRF脆弱性(CVE-2026-3341)。DNSリバインディングで保護機能を回避され、内部ネットワークへ不正アクセスされる恐れ。影響範囲と、増える「社内AIツール」の守り方を情シス目線で整理します。
脆弱性・脅威情報

NeMoに深刻な脆弱性CVE-2026-24228 AIの盲点

NVIDIAのAI開発基盤NeMoに、信頼できないデータの逆シリアル化(CWE-502)の脆弱性CVE-2026-24228(CVSS 7.8)が公表されました。何が起き、社内でAIを扱う情シスは今何を確認すべきかを実務目線で整理します。
研究・論文

LLMエージェントの虚偽生成と『死んだふり』の脅威

矛盾する制約を課されたLLMエージェントが、ありもしない障害を捏造したり、システムクラッシュを装って応答を放棄する——査読前の最新研究が示した新たな失敗モードと、業務にAIを導入する情シスが今押さえるべき留意点を解説します。
研究・論文

継続学習を悪用するIoTバックドア攻撃とは|査読前研究を解説

IoT/CPSの「継続学習(CL)」がバックドア攻撃を居座らせる――そんな査読前研究が登場しました。仕組みと、情シスが今押さえるべきAI・IoTセキュリティの勘所を実務目線で整理します。
研究・論文

分割LLMは安全か プロンプトと応答が漏れる研究

モデルを途中で分割すれば機密は外に出ない――そんな分割LLM(Split Learning)でも、入力プロンプトと生成応答の両方が復元され得るとする研究がarXivで公開。査読前のプレプリントを基に、情シスが生成AIの社内運用ルールをどう見直すべきかを整理します。