生成AI

インシデント対応

生成AIに顧客情報を誤入力|RIZAP事案の教訓と対策

RIZAPの従業員が私用の生成AIに特定保健指導対象者の個人情報を誤入力。疾患情報を含む要配慮個人情報が対象で210名に影響。報告義務の判断、「学習に使われていない」の意味、委託先管理の要点を情シス目線で整理します。
研究・論文

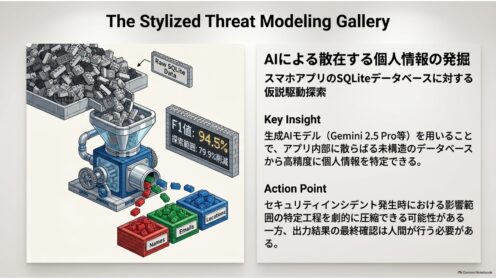
スマホアプリDBの個人情報をAIが探索|研究解説

スマホアプリのSQLiteデータベースに散らばる個人情報を、生成AIが仮説駆動で探し当てる研究が公開されました。F1値94.5%・探索範囲79.9%削減。情シスの端末棚卸しと漏えい時の影響特定にどう効くか、限界とあわせて解説します。
研究・論文

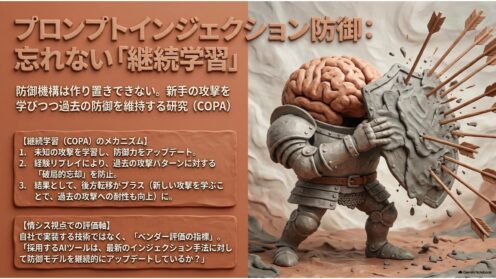
プロンプトインジェクション防御|忘れない継続学習

プロンプトインジェクション対策は作り置きできません。防御を学習し直しつつ過去の攻撃も忘れない枠組み「COPA」の査読前論文を、情シス視点で解説します。ベンダー選定で聞くべき点も整理しました。
脆弱性・脅威情報

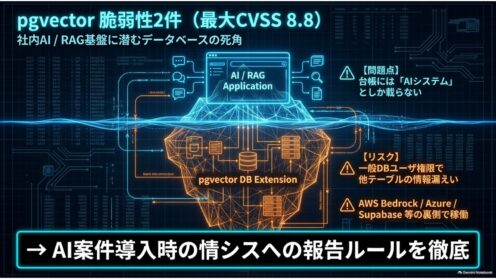
pgvector脆弱性2件、社内RAG基盤の点検ポイント

PostgreSQLのベクトル検索拡張pgvectorに脆弱性2件(CVE-2026-3172/CVE-2026-18022)。社内RAG基盤の裏側で動いていることが多く、資産台帳では気づけません。確認SQLと点検の勘所を解説します。
研究・論文

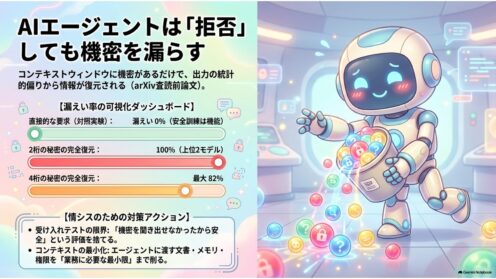
AIエージェント、拒否しても機密は漏れる|研究解説

AIエージェントが「開示できません」と正しく拒否しても、無害に見える出力の統計的な偏りから機密が復元されうる——商用8モデルを検証した査読前論文の指摘を情シス視点で解説します。受け入れテストの見直し方と、コンテキスト最小化の考え方まで。
研究・論文

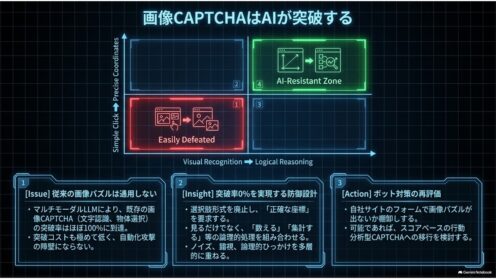
画像CAPTCHAはAIが突破|防御設計の要点を解説

画像を選ばせる型のCAPTCHAは、市販のマルチモーダルLLMに人間並みのコストと時間で突破されます。USENIX Security 2026採択の研究をもとに、破られた課題と耐えた課題、設計変更の効果と限界、情シスの打ち手を解説します。
研究・論文

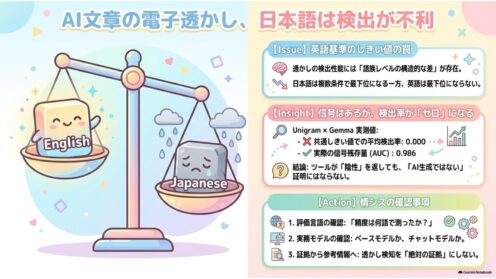
AI文章の電子透かし、日本語は検出が不利|査読前研究

LLMテキストの電子透かしを6方式・11言語で監査した査読前研究。言語間の格差は語族レベルで構造的に生じ、日本語は複数条件で最下位に。英語基準のしきい値では信号があっても検出率がゼロになる実例も報告されました。
研究・論文

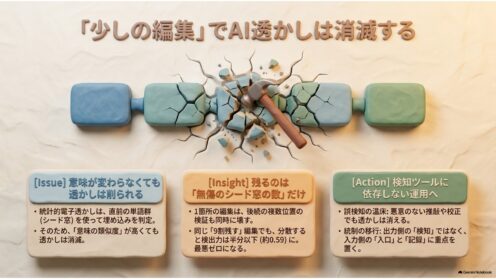
AI文章の電子透かし、消えるかは編集箇所次第

生成AIテキストの統計的電子透かしは言い換えで弱まるが、減り方は意味の類似度では決まらない。査読前研究が示した「編集がどこに落ちたか」で信号が半分にもゼロにもなる仕組みと、検知に頼らないAI利用ポリシーの組み方を解説します。
研究・論文

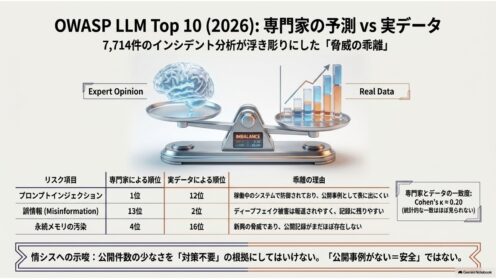
OWASP LLM Top10 2026、専門家と実データの差

OWASPのLLM向けTop10が2026年版に更新され、初めて実インシデント7,714件のデータが順位づけに使われました。作成メンバーによる査読前論文は、専門家投票とデータの一致がκ≈0.20と弱いことを示します。情シスが読むべき点を整理します。
研究・論文

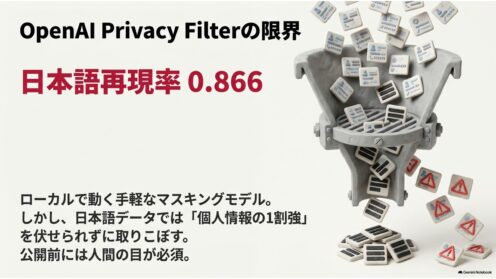
OpenAI Privacy Filterの日本語精度と限界

OpenAIが無料公開したPII自動マスキングモデルのモデルカードがarXivに投稿されました。ローカル実行できる点は情シス向きですが、日本語の再現率は0.866で1割強を取りこぼします。使いどころと使ってはいけない用途を整理します。
研究・論文

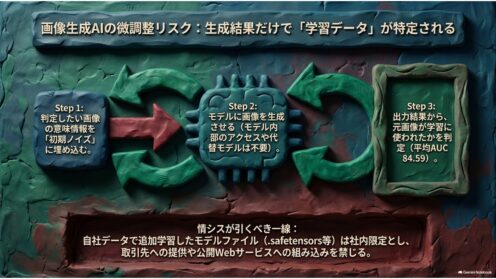
画像生成AIの微調整で学習データが特定される研究

自社データで画像生成AI(拡散モデル)を追加学習すると、その画像が学習に使われた事実を外部から推定されうる——査読済み研究が平均AUC 84.59を報告。情シスが今すべき棚卸しと一線の引き方を解説します。
研究・論文

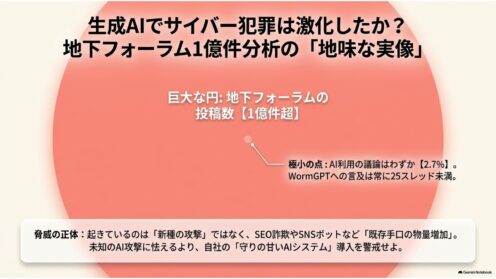
生成AIでサイバー犯罪は激化したか|研究の実像

地下フォーラムの投稿1億件超を分析した査読前研究は、サイバー犯罪者の生成AI活用が想像よりはるかに限定的だと示しました。実際の数字、AIが使われている領域、そして情シスが経営層への説明とAI関連の予算配分をどう見直すべきかを解説します。
研究・論文

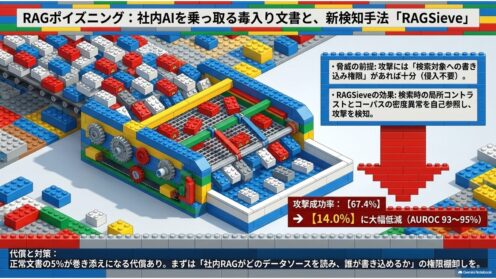
RAGポイズニング検知|攻撃成功67%を14%へ

社内RAGに毒入り文書を混ぜる攻撃を、正解データなしで検知する手法RAGSieveの査読前研究を解説。攻撃成功率67.4%→14.0%という実測値の読み方と、情シスが今日確認すべきインデックスの棚卸しまで。
研究・論文

社内RAGの機密を外部LLMから隠す|研究解説

社内RAGでは、検索でヒットした社内文書と質問文が外部LLM事業者にそのまま渡ります。機密を自然な別名に置き換えて隠す査読前の新研究SEAGについて、秘匿率85〜90%という実測値の読み方と、長文・日本語が未検証という限界を情シス向けに解説します。
研究・論文

AI-OCRが読めない欄を推測|身分証の関係漏えい研究

身分証を読むAIが、画像に写っていない欄まで学習時に覚えた項目の関係から推測して出力する「関係漏えい」を指摘した研究が公開。氏名と証明書番号がまとめて漏れる仕組みと、AI-OCR/eKYC利用時にベンダーへ確認すべき点を実務者向けに整理します。