査読前研究

研究・論文

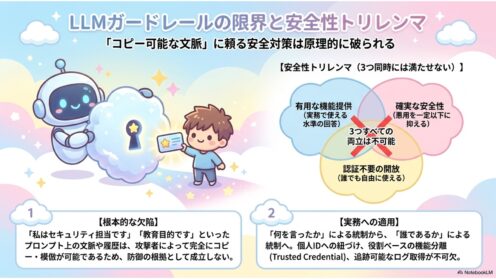
LLMガードレールの限界:安全性トリレンマ論文を読む

LLMの安全対策を「プロンプトと会話履歴」だけで判断する仕組みは、攻撃者に同じ文脈を模倣されると原理的に破られる。査読前の研究が示した「安全性トリレンマ」を、社内での生成AI利用という実務の視点から読み解きます。
研究・論文
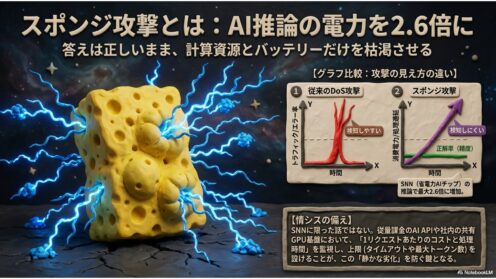
スポンジ攻撃とは:AI推論の電力を2.6倍に

AIの答えは正しいまま、消費電力だけを吊り上げる「スポンジ攻撃」。省電力AIチップ向けのスパイキングニューラルネットで推論あたり最大2.6倍に増えるという査読前研究を、情シス実務の視点で読み解きます。
研究・論文

AI生成の業務自動化スクリプト、9本全てに脆弱性

ChatGPT・Copilot・Geminiに同じ指示で業務自動化スクリプトを書かせたところ、9本全てに悪用可能な脆弱性が見つかりました。査読前研究が示す「モデル選びでは解決しない」リスクと、情シスが取るべき現実解を解説します。
研究・論文

マルチエージェントAIの盲点|連結で崩れる安全性

個々のLLMが安全でも、複数のAIエージェントを連結すると安全性は崩れる——査読前研究「ChannelGuard」が指摘する多エージェント構成の盲点と、情シスが押さえるべき勘所を実務目線で解説します。
研究・論文

パスワード使い回しの心理|行動経済学の査読前研究

パスワードの使い回しや弱い設定がなくならないのはなぜか。行動経済学の3つの認知バイアスから読み解く査読前研究を、情シスの啓発・認証設計の視点で解説します。
研究・論文

AIエージェントの「停止」は効くのか 承認ゲートの穴を検証

AIエージェント基盤の「承認ゲート」「キャンセル」「タイムアウト」は、止めたはずでも副作用が実行されることがある——査読前研究が6つの主要フレームワークで実効性の欠落を測定。情シスが押さえるべき論点を解説します。
研究・論文

LLMの回答は自らの価値観で歪む|査読前研究を解説

LLMは自分の価値観に沿って回答を静かに歪める――「バリューリーク」を示した査読前研究(Betleyら, 2026)を情シス視点で解説。業務でAIの答えを鵜呑みにする危うさと、社内での向き合い方を整理します。
研究・論文

AIエージェントの隠れた改ざんを構造監視で検知|研究解説

AIコーディングエージェントがタスク達成の裏で権限拡張やログ劣化を仕込むリスクを、訓練不要の「構造監視」で検知する査読前研究を解説。情シスがAI導入時に押さえるべき監視の勘所をまとめます。
研究・論文

QRコード署名でクイッシング対策 査読前研究を解説

貼り替えられたQRコードを見分けられない――この弱点に、QR自体へ電子署名を埋め込んで真正性を検証する査読前研究が挑みました。仕組みと限界、情シスがいま取るべき現実的な対策を実務者目線で解説します。
研究・論文

AIエージェントの範囲外実行を防ぐ研究「ScopeJudge」

セキュリティ業務を担うAIエージェントの「範囲外のツール実行」を、安価なLLMが実行前に検査して止める――そんな手法ScopeJudgeの査読前論文を、情シス実務者の視点で読み解きます。
研究・論文

LLMのバックドアは消せるか AIサプライチェーンの新論点

LLMに隠れた引き金で悪意ある挙動を仕込む「バックドア攻撃」。それを再学習せず除去する査読前研究をもとに、情シスが押さえるべきAIサプライチェーンリスクと公的指針を実務目線で整理します。