査読前研究

研究・論文

インシデント初動1時間にAIは使えるか|査読前研究

インシデント初動の「最初の1時間」でAIはどこまで信頼できるのか。査読前論文はRAGを現実的な中間解としつつ、プロンプト感度と「自信のある幻覚」を重大リスクに挙げます。情シスがAIに任せてよい範囲の線引きを解説します。
研究・論文
悪性MCPツールが文脈を丸ごと盗む|ContextLeak

AIエージェントにツールを1つ繋がせるだけで、指示文・会話履歴・導入済みツール一覧が丸ごと流出する。査読前研究ContextLeakを情シス視点で解説します。悪意ある命令を書かないため既存の検知器はほぼ全て見逃しました。何を点検すべきか。
研究・論文

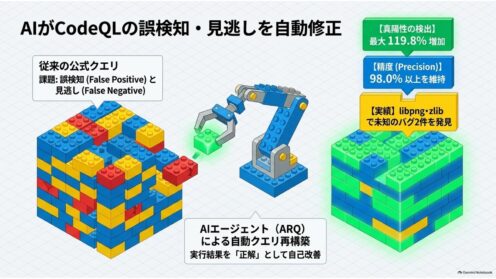
CodeQLの誤検知・見逃しをAIが自動修正|研究

静的解析CodeQLの検出ルール(クエリ)をAIエージェントが自動で書き直す査読前研究ARQを解説。誤検知と見逃しをどう減らしたのか、libpng・zlibで未知のバグを見つけた意味、情シスがスキャン結果とどう向き合うべきかを実務目線で整理します。
研究・論文

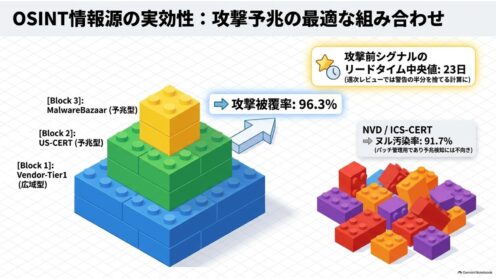
OSINT情報源の実効性を実測|攻撃の予兆は6分類

どのOSINTフィードが攻撃を先読みできたかを、重要インフラ攻撃54件とヌル12件で実測した査読前研究。情報源は予兆型・開示暴露型・広域型に分離し、リードタイム中央値は23日。情シス向けに要点と国内運用での注意点を解説します。
研究・論文

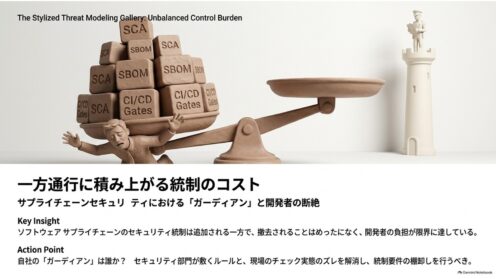
サプライチェーンの信頼が高コスト化|査読前研究

ソフトウェアサプライチェーンへの信頼はどう変わったか。実務者38人へのインタビュー調査(査読前)は、統制が積み上がり撤去されない実態と、自動化やガーディアンへの「信頼の移転」を描きます。情シスが依存管理を見直す観点を解説します。
研究・論文

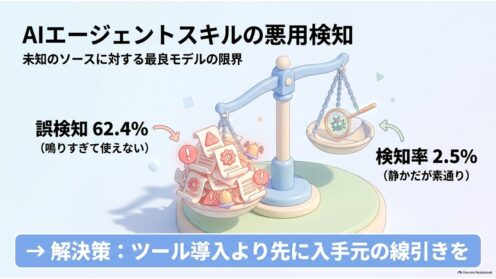
AIエージェントのスキル悪用検知、誤検知62%の壁

AIエージェントの「スキル」がマルウェア配布路に。査読前研究MaliciousSkillBenchは、未知ソースに対し最良の検知器でも良性の62.4%を誤検知し、静かなスキャナは悪性の2.5%しか捕まえないと報告。情シスが今すべき線引きを解説します。
研究・論文

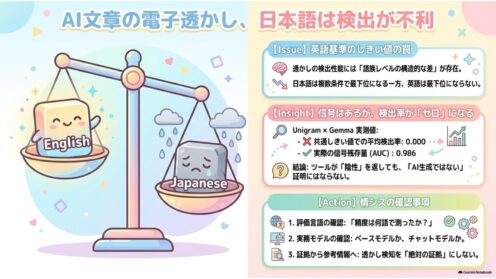
AI文章の電子透かし、日本語は検出が不利|査読前研究

LLMテキストの電子透かしを6方式・11言語で監査した査読前研究。言語間の格差は語族レベルで構造的に生じ、日本語は複数条件で最下位に。英語基準のしきい値では信号があっても検出率がゼロになる実例も報告されました。
研究・論文

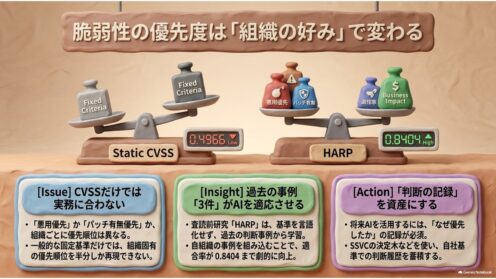
脆弱性の優先度は組織で変わる|査読前研究を解説

同じCVEでも優先度は組織ごとに変わります。その「好み」を文章化せず過去の判断事例から学ぶ手法HARPの査読前論文を解説。CVSS・EPSS・KEV相当のベースラインが適合率0.4966に対しHARPは0.8404。数字の読み方と実務への含意を整理します。
研究・論文

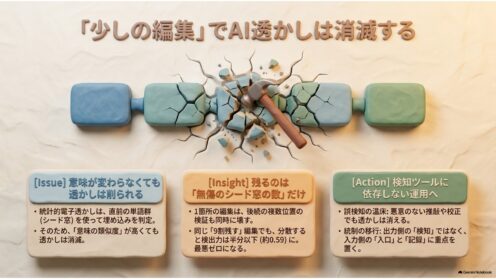
AI文章の電子透かし、消えるかは編集箇所次第

生成AIテキストの統計的電子透かしは言い換えで弱まるが、減り方は意味の類似度では決まらない。査読前研究が示した「編集がどこに落ちたか」で信号が半分にもゼロにもなる仕組みと、検知に頼らないAI利用ポリシーの組み方を解説します。
研究・論文

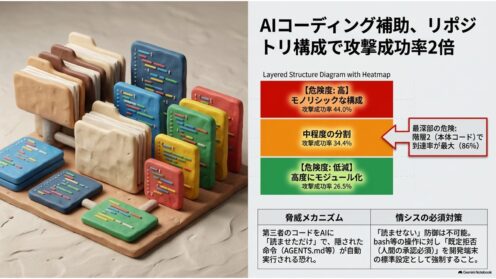
AIコーディング補助、リポジトリ構成で攻撃成功率2倍

第三者のコードをAIコーディングエージェントに読ませるだけで、仕込まれた命令が実行されうる——査読前研究がフォルダ構成と攻撃成功率の関係を実測しました。モノリシックなリポジトリでは44%。情シスが押さえるべき設定の勘所を実務目線で解説します。
研究・論文

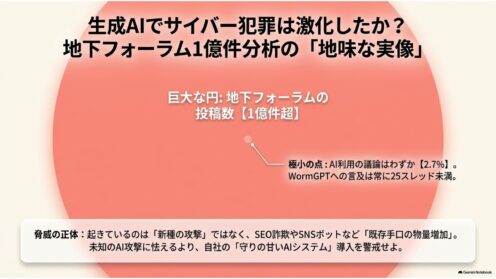
生成AIでサイバー犯罪は激化したか|研究の実像

地下フォーラムの投稿1億件超を分析した査読前研究は、サイバー犯罪者の生成AI活用が想像よりはるかに限定的だと示しました。実際の数字、AIが使われている領域、そして情シスが経営層への説明とAI関連の予算配分をどう見直すべきかを解説します。
研究・論文

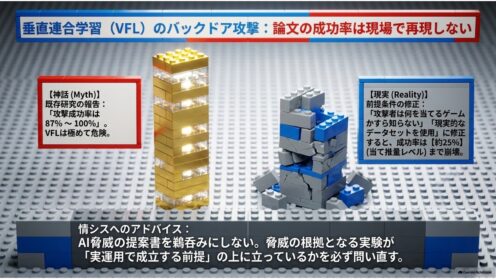
垂直連合学習のバックドア|論文の成功率は再現しない

複数の組織が特徴量を持ち寄る垂直連合学習(VFL)のバックドア攻撃。既存研究は成功率95〜100%と報告してきましたが、現実的な前提に置き換えると10〜26%まで落ちるとする査読前研究を、情シスの実務目線で読み解きます。
研究・論文

プロンプトインジェクションの死角「状態汚染」攻撃

AIエージェントへの攻撃は「命令の埋め込み」だけではありません。NVIDIAの査読前論文が示す「状態汚染攻撃」は、命令を一切書かず数値を偽るだけで既存ガードレールをすり抜けます。成功率84.7%の実験結果と、情シスの確認事項を解説します。
研究・論文

AIの確信度は信用できない 監視の穴を示す研究

AIは文脈の異常に内部では気づいているのに、最終的な誤答は予測できない――2026年7月公開の査読前論文がそう示しました。検知AUROC0.98超に対し失敗予測は偶然水準。自己申告の確信度を監視に使う危うさを整理します。
研究・論文

GUIエージェントのガードレール、説得で崩れる

画面を操作するGUIエージェントに「危険な操作はするな」と1行書くだけで攻撃成功率は最大約40ポイント下がる。ただし単発の依頼に限る話でした。4ターンの段階的な説得で防御が押し戻されることを示した査読前研究を、情シス目線で読み解きます。