LLM

研究・論文

インシデント初動1時間にAIは使えるか|査読前研究

インシデント初動の「最初の1時間」でAIはどこまで信頼できるのか。査読前論文はRAGを現実的な中間解としつつ、プロンプト感度と「自信のある幻覚」を重大リスクに挙げます。情シスがAIに任せてよい範囲の線引きを解説します。
研究・論文
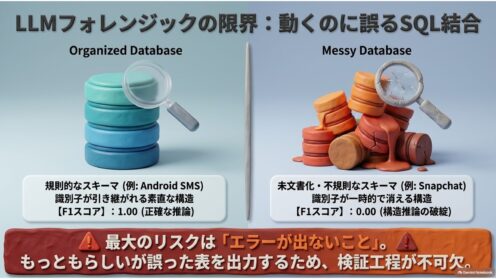
LLMフォレンジックの限界|動くのに誤るSQL結合

AIエージェントに未文書化のアプリDBを調べさせると、エラーなく実行できるのに構造的に誤ったSQL結合を返すことがある——査読を経た新研究の指摘を、情シスの実務目線で読み解きます。
研究・論文

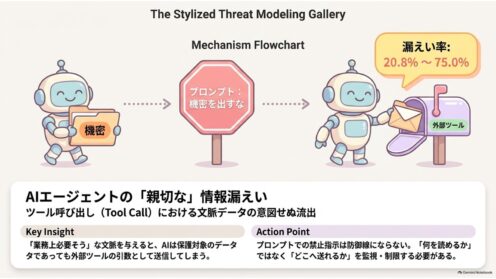
AIエージェントのツール呼び出しで機密流出|査読前研究

AIエージェントは読める情報を外部ツールの引数として送ってしまう。業務上必要そうに見せるだけで機密が混ざり、開示率は最大75%。査読前研究の指摘を情シス視点で解説し、社内のAI連携で点検すべき箇所と、ツール選定基準まで示します。
研究・論文

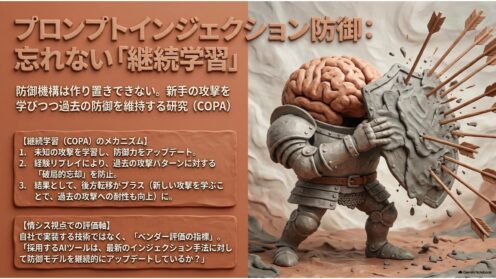
プロンプトインジェクション防御|忘れない継続学習

プロンプトインジェクション対策は作り置きできません。防御を学習し直しつつ過去の攻撃も忘れない枠組み「COPA」の査読前論文を、情シス視点で解説します。ベンダー選定で聞くべき点も整理しました。
研究・論文

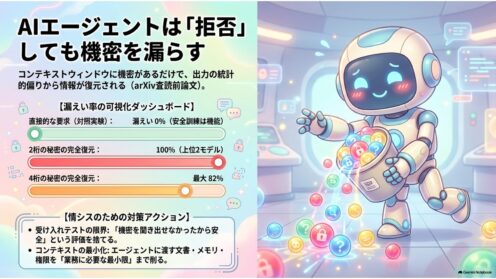
AIエージェント、拒否しても機密は漏れる|研究解説

AIエージェントが「開示できません」と正しく拒否しても、無害に見える出力の統計的な偏りから機密が復元されうる——商用8モデルを検証した査読前論文の指摘を情シス視点で解説します。受け入れテストの見直し方と、コンテキスト最小化の考え方まで。
研究・論文

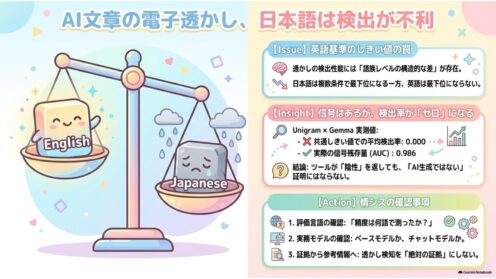
AI文章の電子透かし、日本語は検出が不利|査読前研究

LLMテキストの電子透かしを6方式・11言語で監査した査読前研究。言語間の格差は語族レベルで構造的に生じ、日本語は複数条件で最下位に。英語基準のしきい値では信号があっても検出率がゼロになる実例も報告されました。
研究・論文

脆弱性の優先度は組織で変わる|査読前研究を解説

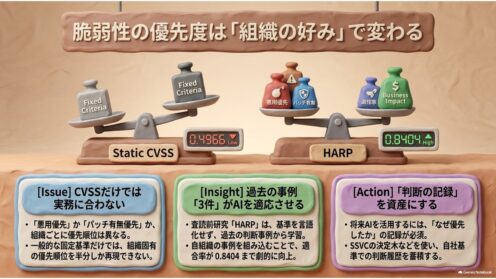
同じCVEでも優先度は組織ごとに変わります。その「好み」を文章化せず過去の判断事例から学ぶ手法HARPの査読前論文を解説。CVSS・EPSS・KEV相当のベースラインが適合率0.4966に対しHARPは0.8404。数字の読み方と実務への含意を整理します。
研究・論文

AI文章の電子透かし、消えるかは編集箇所次第

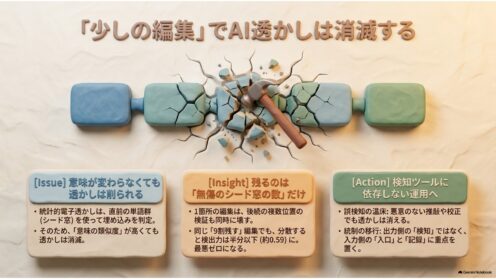
生成AIテキストの統計的電子透かしは言い換えで弱まるが、減り方は意味の類似度では決まらない。査読前研究が示した「編集がどこに落ちたか」で信号が半分にもゼロにもなる仕組みと、検知に頼らないAI利用ポリシーの組み方を解説します。
研究・論文

OWASP LLM Top10 2026、専門家と実データの差

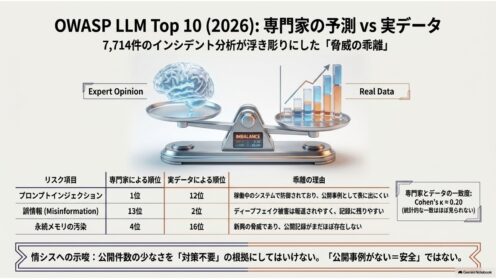
OWASPのLLM向けTop10が2026年版に更新され、初めて実インシデント7,714件のデータが順位づけに使われました。作成メンバーによる査読前論文は、専門家投票とデータの一致がκ≈0.20と弱いことを示します。情シスが読むべき点を整理します。
研究・論文

LLMで脆弱性の自動検証は可能か|査読前研究

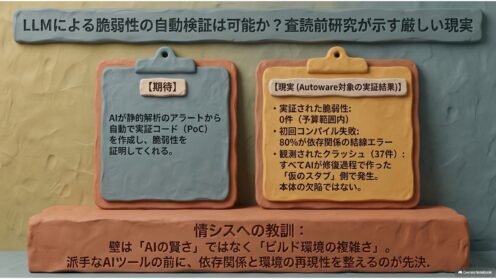
静的解析が挙げた脆弱性候補を、LLMに実際に動かして確かめさせられるか。自動運転ソフトAutowareを対象にした査読前研究は「予算内で1件も実証できなかった」と報告します。壁はAIの賢さではなくビルド統合でした。情シス実務への含意を解説します。
研究・論文

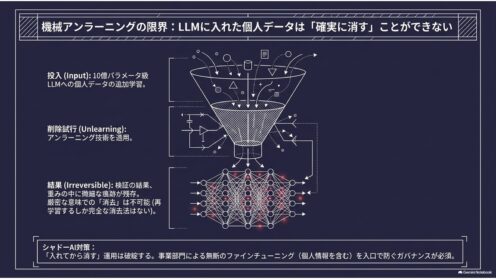
機械アンラーニングは本当に消せるか|研究解説

AIに学習させてしまった個人データは後から消せるのか。学習を「再生」してビット単位で一致する削除後モデルを作った査読前研究を読み解き、事前準備がなければ厳密削除は成立しないという実務上の含意を情シス視点で整理します。
研究・論文

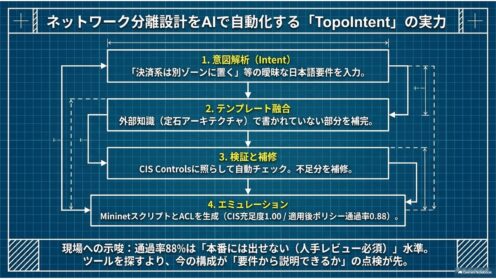
ネットワーク分離設計をAIで自動化|研究解説

「この業務系はDMZから直接触らせない」といった日本語の要件から、ゾーン構成とACLまで自動生成する研究TopoIntentを解説。査読前論文の数値の読み方と、情シスが実務で使える範囲を率直に整理します。
研究・論文

AIエージェント防御の自己進化|論文解説

LLMエージェントの防御ルールを人手で作り込む方式は限界がある——そう指摘し、防御を自動で進化させる枠組みHARDを提案した査読前論文を解説します。適応攻撃では成功率26.5%が残る点など、情シスが押さえるべき現実的な示唆を整理しました。
研究・論文

社内RAGの機密を外部LLMから隠す|研究解説

社内RAGでは、検索でヒットした社内文書と質問文が外部LLM事業者にそのまま渡ります。機密を自然な別名に置き換えて隠す査読前の新研究SEAGについて、秘匿率85〜90%という実測値の読み方と、長文・日本語が未検証という限界を情シス向けに解説します。
研究・論文

AIトリアージの保証は「何もしない」でも達成|研究解説

「誤判定率は5%以下を保証」というAIトリアージの謳い文句は、1件も自動処理しなければ100%達成できてしまう。この構造的な空虚さを指摘し、実験で再現した査読前論文を、製品評価の観点から読み解きます。