AIエージェント

脆弱性・脅威情報

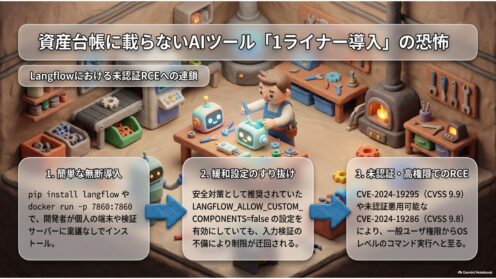
Langflowに深刻なRCE3件、緩和設定も回避

AIエージェント開発ツールLangflowに深刻なRCE脆弱性が3件。1.0.0~1.11.1が対象で修正版は1.11.2です。1件は認証不要、2件はカスタムコンポーネント無効化の緩和設定を回避します。確認手順と対応の要点を解説。
脆弱性・脅威情報
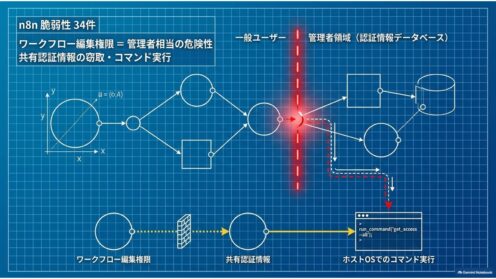
n8nに脆弱性34件 認証情報の窃取が可能

ワークフロー自動化基盤n8nで2026年8月に34件の脆弱性が公表。ワークフローを編集できる一般ユーザーが共有された認証情報を盗み、ホスト上でコマンドを実行できるものが並びます。自前ホスト中の情シスがすべき更新と点検を整理しました。
研究・論文

悪性MCPツールが文脈を丸ごと盗む|ContextLeak

AIエージェントにツールを1つ繋がせるだけで、指示文・会話履歴・導入済みツール一覧が丸ごと流出する。査読前研究ContextLeakを情シス視点で解説します。悪意ある命令を書かないため既存の検知器はほぼ全て見逃しました。何を点検すべきか。
脆弱性・脅威情報

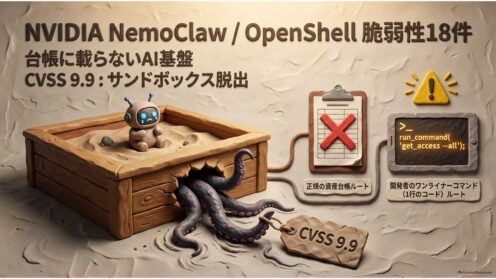
NVIDIA NemoClaw/OpenShellに脆弱性18件

NVIDIAがAIエージェント実行基盤NemoClaw・OpenShellの脆弱性18件を公表しました。最大はCVSS9.9のサンドボックス脱出。資産台帳に載らないワンライナー導入という情シス泣かせの実態と、自社での確認手順を解説します。
研究・論文

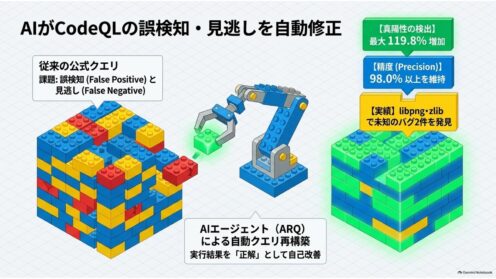
CodeQLの誤検知・見逃しをAIが自動修正|研究

静的解析CodeQLの検出ルール(クエリ)をAIエージェントが自動で書き直す査読前研究ARQを解説。誤検知と見逃しをどう減らしたのか、libpng・zlibで未知のバグを見つけた意味、情シスがスキャン結果とどう向き合うべきかを実務目線で整理します。
研究・論文

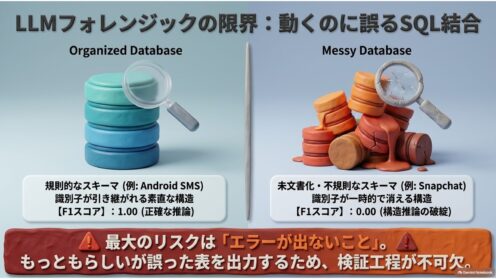
LLMフォレンジックの限界|動くのに誤るSQL結合

AIエージェントに未文書化のアプリDBを調べさせると、エラーなく実行できるのに構造的に誤ったSQL結合を返すことがある——査読を経た新研究の指摘を、情シスの実務目線で読み解きます。
研究・論文

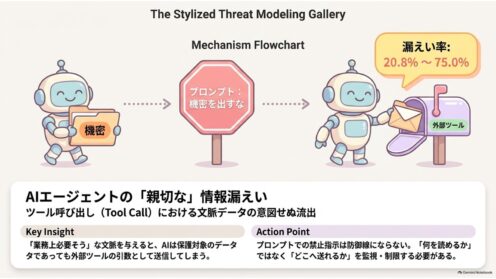
AIエージェントのツール呼び出しで機密流出|査読前研究

AIエージェントは読める情報を外部ツールの引数として送ってしまう。業務上必要そうに見せるだけで機密が混ざり、開示率は最大75%。査読前研究の指摘を情シス視点で解説し、社内のAI連携で点検すべき箇所と、ツール選定基準まで示します。
研究・論文

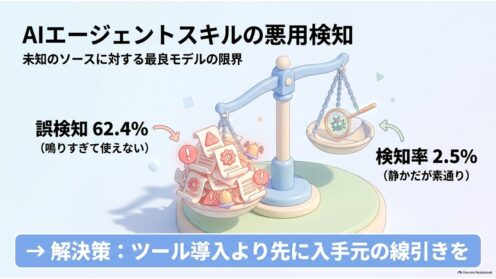
AIエージェントのスキル悪用検知、誤検知62%の壁

AIエージェントの「スキル」がマルウェア配布路に。査読前研究MaliciousSkillBenchは、未知ソースに対し最良の検知器でも良性の62.4%を誤検知し、静かなスキャナは悪性の2.5%しか捕まえないと報告。情シスが今すべき線引きを解説します。
研究・論文

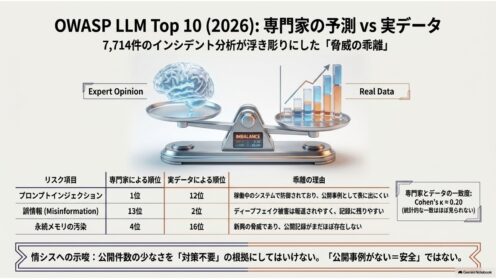
OWASP LLM Top10 2026、専門家と実データの差

OWASPのLLM向けTop10が2026年版に更新され、初めて実インシデント7,714件のデータが順位づけに使われました。作成メンバーによる査読前論文は、専門家投票とデータの一致がκ≈0.20と弱いことを示します。情シスが読むべき点を整理します。
研究・論文

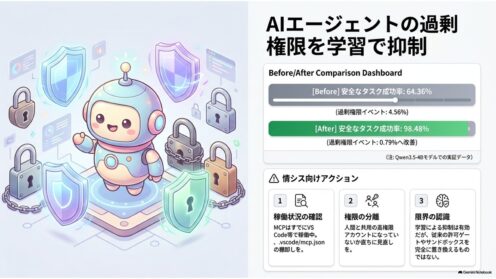
AIエージェントの過剰権限を学習で抑制|研究解説

AIエージェントは頼まれていない権限まで使ってしまう。この過剰権限をモデル自身に学習させて減らす査読前研究を解説。安全な成功率64%→98%の数字と、許可ゲートを置き換えられない理由を情シス視点で読み解きます。
脆弱性・脅威情報

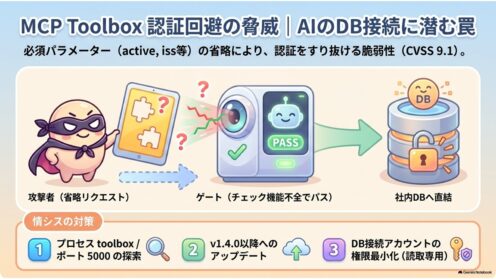
MCP Toolboxに認証回避3件|AIのDB接続が危険

Google製MCPサーバ「MCP Toolbox for Databases」に認証・認可回避の脆弱性3件(CVE-2026-11717ほか、最大CVSS9.1)。影響は1.0.0〜1.3.0、修正はv1.4.0。台帳に載らないAI用DB接続サーバの探し方を解説。
研究・論文

MCPエージェント評価、攻撃成功58件が誤り|研究解説

MCPで外部ツールに接続するAIエージェントの安全性評価を監査した査読前論文。採点器が「攻撃条件かどうか」のメタデータで結果を判定していたため、58件の攻撃成功・乗っ取り試行が正規の完了に訂正された。ベンダー評価数値の読み方を実務目線で解説します。
研究・論文

AIエージェント防御の自己進化|論文解説

LLMエージェントの防御ルールを人手で作り込む方式は限界がある——そう指摘し、防御を自動で進化させる枠組みHARDを提案した査読前論文を解説します。適応攻撃では成功率26.5%が残る点など、情シスが押さえるべき現実的な示唆を整理しました。
研究・論文

AIエージェントの正解は証拠にならない|研究解説

AIエージェントに業務を任せるとき、「正しい結果を出したか」だけで評価すると組織としては危ういと指摘する査読前論文を、情シスの実務目線で解説します。権限・完了証拠・陳腐化という3つの落とし穴と、実験結果の限界まで。
研究・論文

プロンプトインジェクションの死角「状態汚染」攻撃

AIエージェントへの攻撃は「命令の埋め込み」だけではありません。NVIDIAの査読前論文が示す「状態汚染攻撃」は、命令を一切書かず数値を偽るだけで既存ガードレールをすり抜けます。成功率84.7%の実験結果と、情シスの確認事項を解説します。