査読前論文

研究・論文

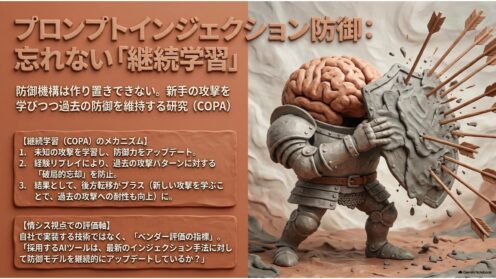
プロンプトインジェクション防御|忘れない継続学習

プロンプトインジェクション対策は作り置きできません。防御を学習し直しつつ過去の攻撃も忘れない枠組み「COPA」の査読前論文を、情シス視点で解説します。ベンダー選定で聞くべき点も整理しました。
研究・論文
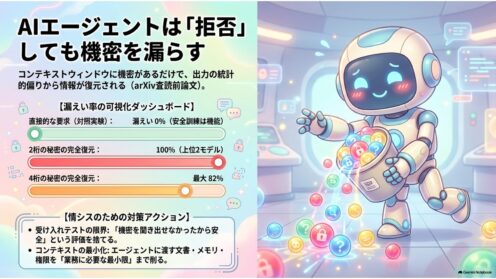
AIエージェント、拒否しても機密は漏れる|研究解説

AIエージェントが「開示できません」と正しく拒否しても、無害に見える出力の統計的な偏りから機密が復元されうる——商用8モデルを検証した査読前論文の指摘を情シス視点で解説します。受け入れテストの見直し方と、コンテキスト最小化の考え方まで。
研究・論文

AIトリアージの保証は「何もしない」でも達成|研究解説

「誤判定率は5%以下を保証」というAIトリアージの謳い文句は、1件も自動処理しなければ100%達成できてしまう。この構造的な空虚さを指摘し、実験で再現した査読前論文を、製品評価の観点から読み解きます。
研究・論文

MCPサーバ91.8%が認証なし|研究解説

インターネットに公開されたMCPサーバ414台を実際に検査した査読前研究を解説します。91.8%がOAuth認証なし、687のツールが制限なしのシェル実行を露出。情シスが自組織で確認すべき点を整理します。
研究・論文

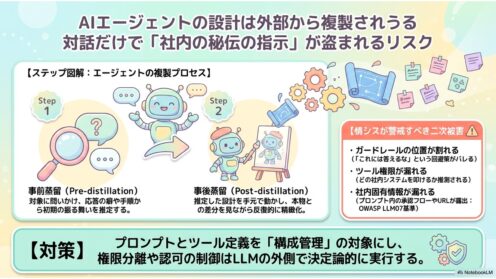
AIエージェントの設計は外部から複製されうる|研究解説

社内AIエージェントの「ハーネス」(指示や連携の設計)は、外から対話するだけで復元されうる——arXivの査読前研究が示したリスクと、情シスが今のうちに整理しておくべき前提を解説します。
研究・論文

セキュリティAIの評価は成功率だけでは不十分|研究解説

セキュリティ用途のAIエージェントは「成功率」だけで評価すると本番運用とズレます。攻撃と防御の両面でコスト(推論・ツール利用)を軸に評価した査読前研究を、情シスの製品選定目線でかみ砕いて解説します。
研究・論文

連合学習でも機密テキストは漏れる 勾配反転攻撃の研究

連合学習は「生データを共有しないから安全」とされがちですが、共有する勾配から機密テキストが最大44%再構成できたとする査読前論文を、情シス実務の視点で読み解きます。
研究・論文

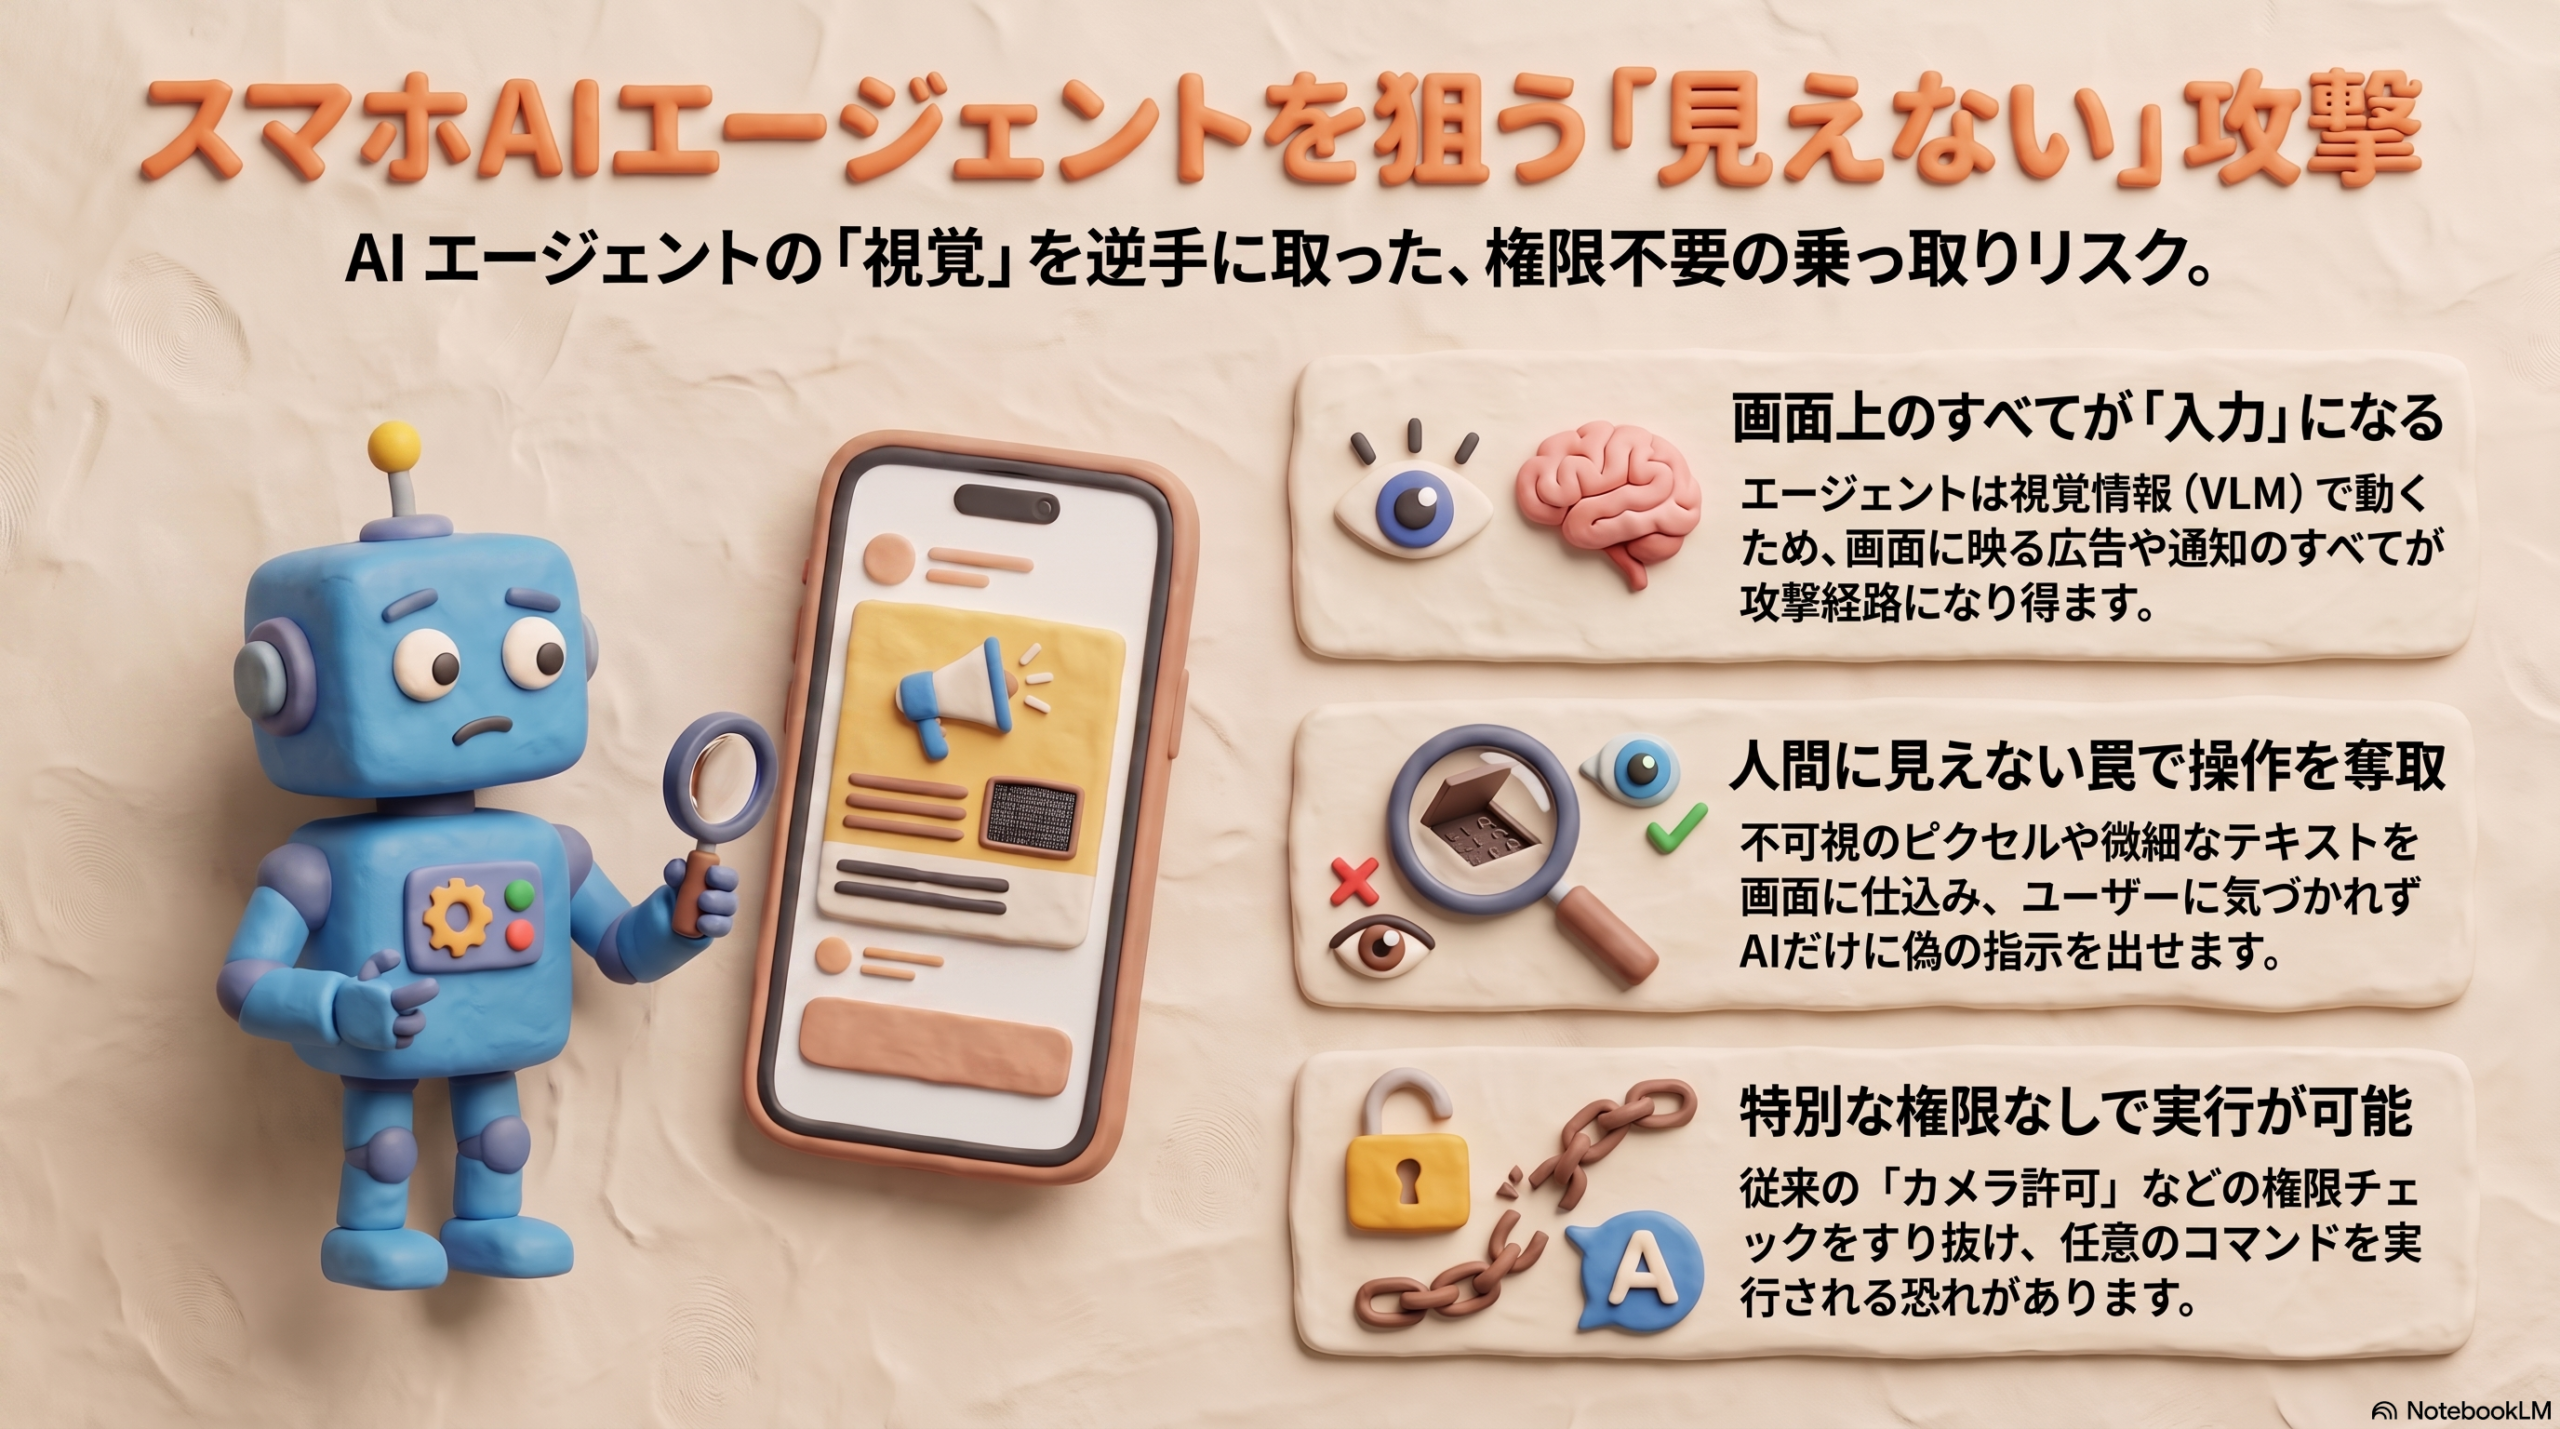
スマホAIエージェントの新攻撃面 VLMを騙す7つの手口

スマホ画面を見て自律操作するVLMベースのAIエージェントに、権限なしで乗っ取り・任意コマンド実行を許す新たな攻撃面があると指摘した査読前論文を、情シス実務者向けに噛み砕いて解説します。
研究・論文

スローダウン攻撃とは:推論AIを狙う新たな脅威

推論するAIをわざと「考えすぎ」に陥らせ、応答を極端に遅らせるスローダウン攻撃。査読前の新研究では、現実世界に置いた文字だけで最大約7倍の遅延が起きました。情シスが知っておくべき新しい可用性リスクを解説します。