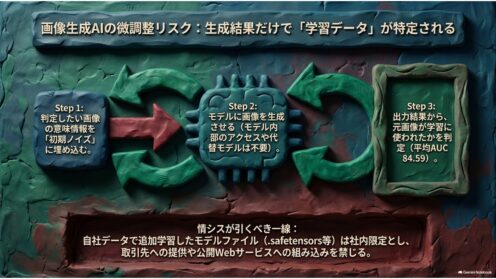
研究・論文 画像生成AIの微調整で学習データが特定される研究 自社データで画像生成AI(拡散モデル)を追加学習すると、その画像が学習に使われた事実を外部から推定されうる——査読済み研究が平均AUC 84.59を報告。情シスが今すべき棚卸しと一線の引き方を解説します。 2026.08.17 研究・論文
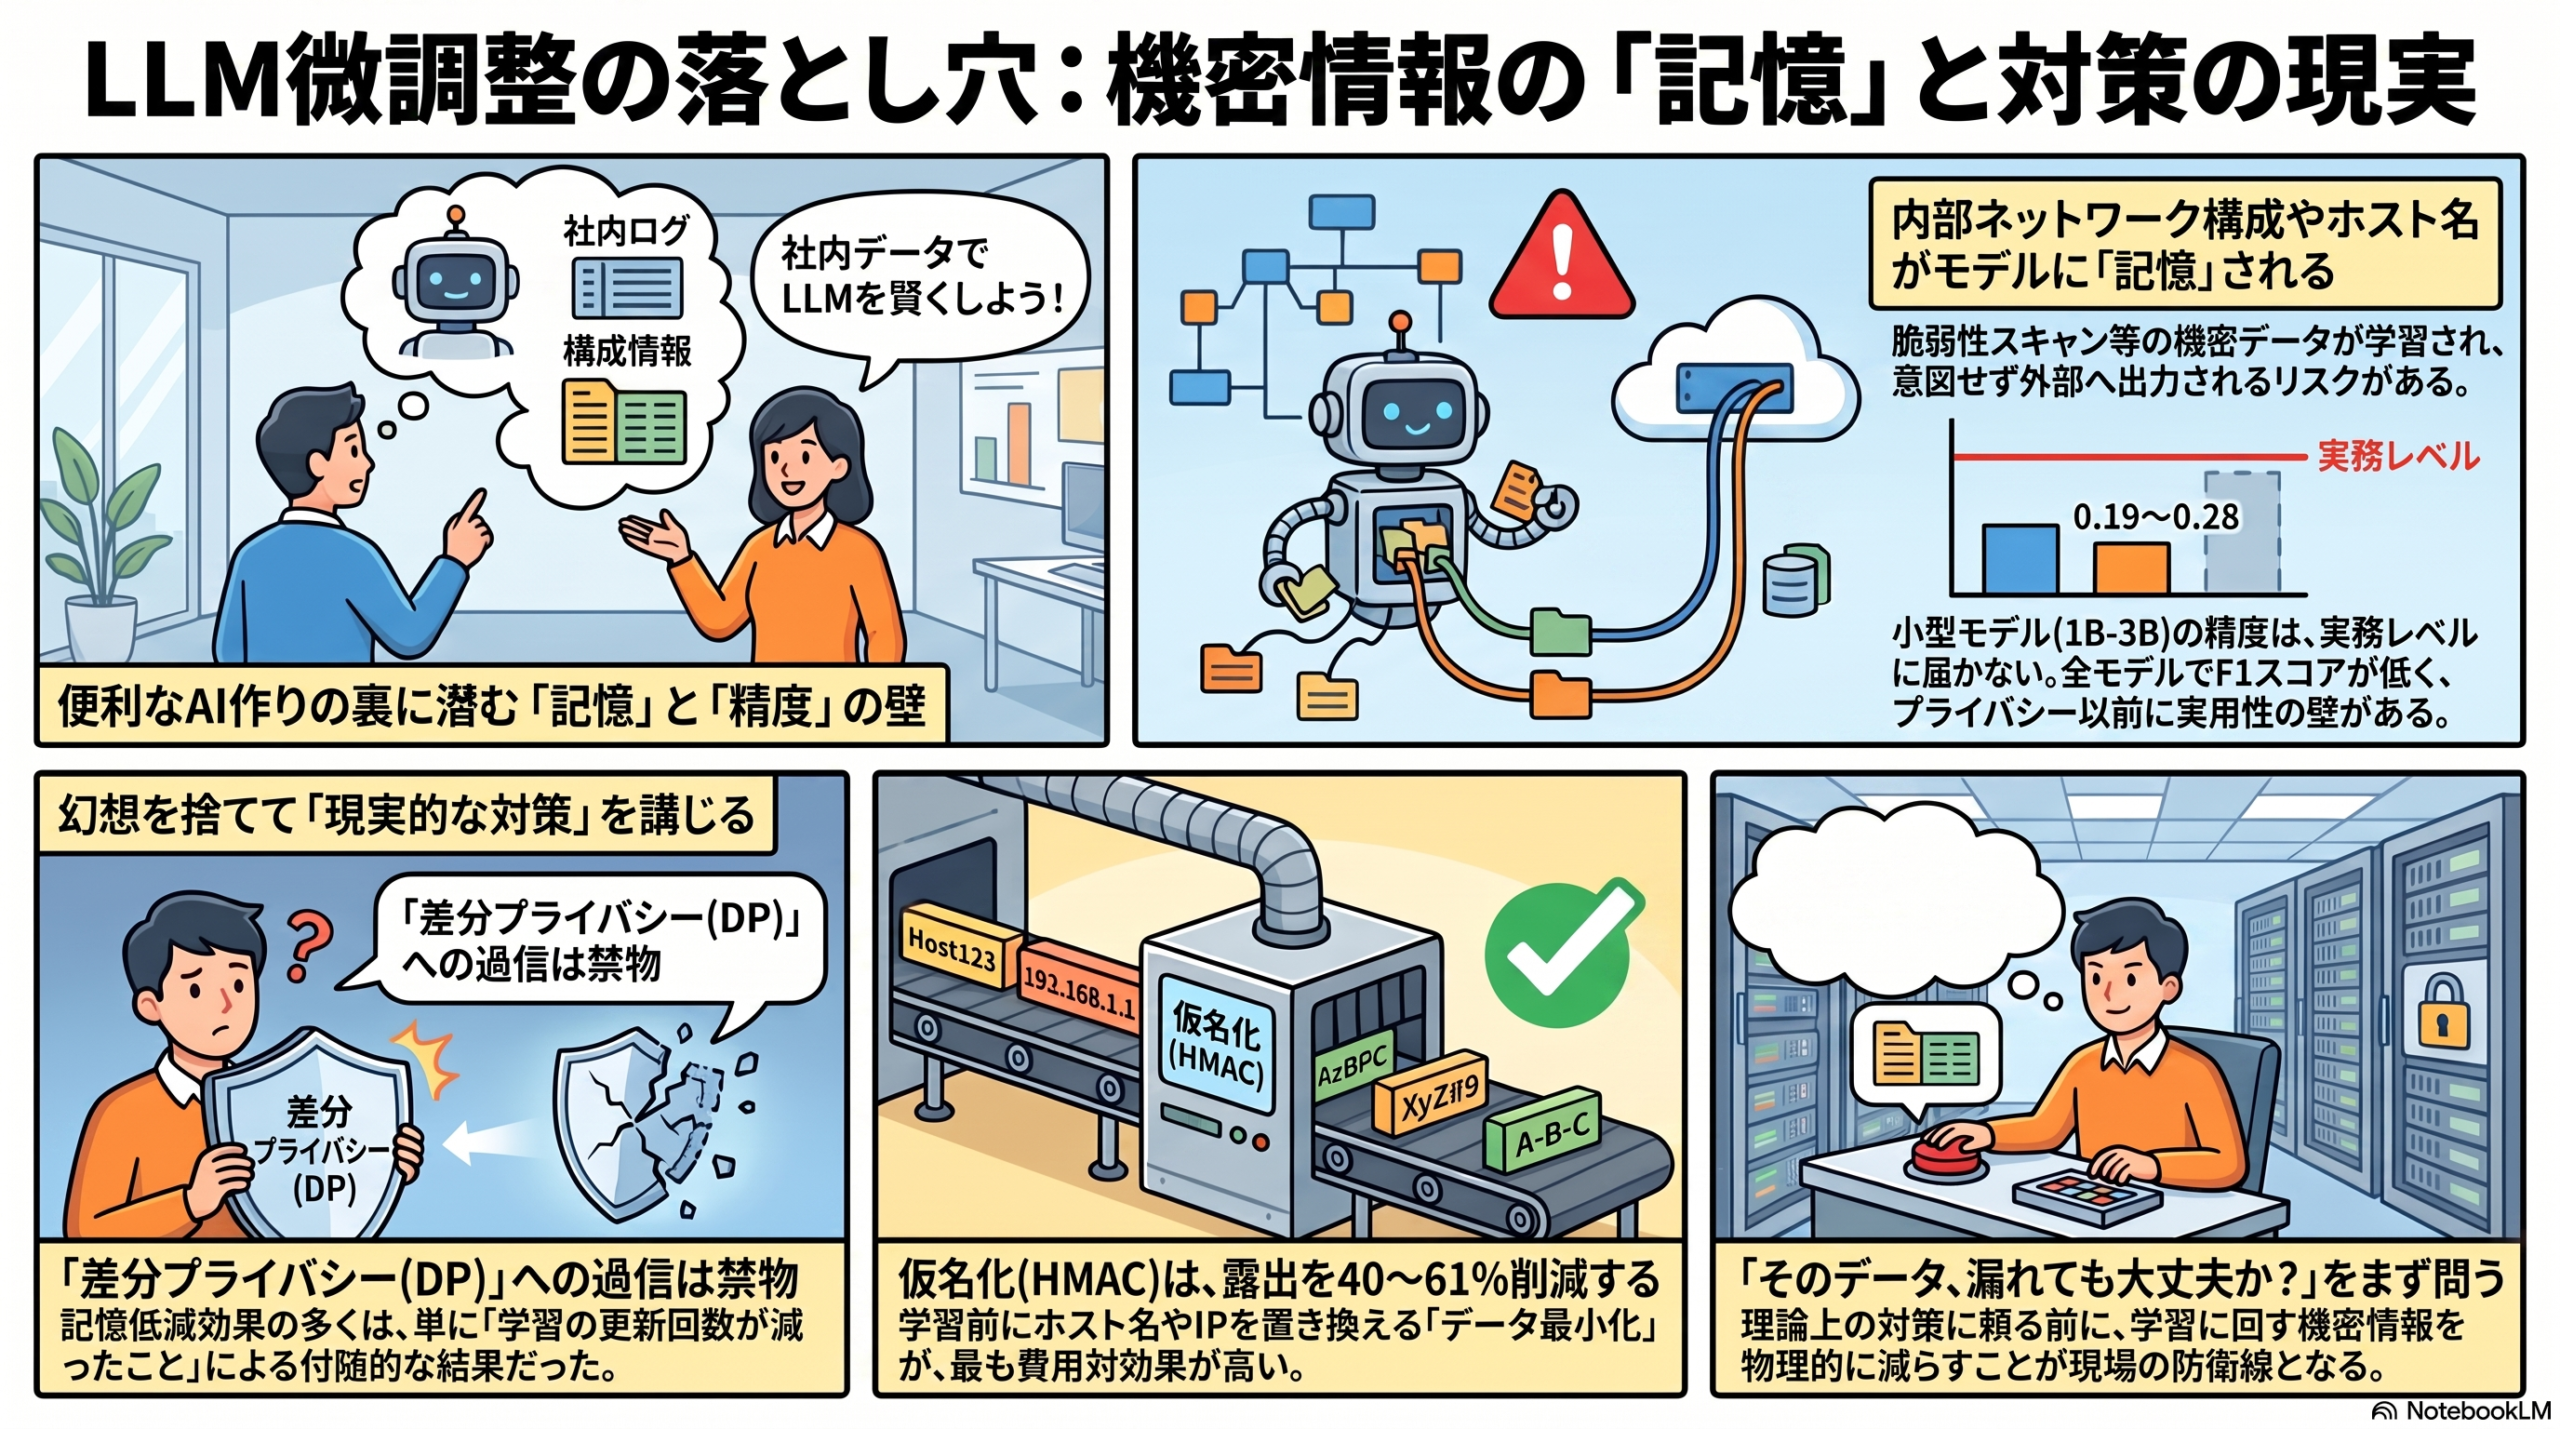
研究・論文 LLM微調整に潜む情報漏洩リスク 査読前研究で読み解く 脆弱性スキャン結果など社内データでLLMを微調整すると、ネットワーク構成が「記憶」され漏れる恐れがあります。査読前研究の知見から、差分プライバシーや仮名化の効果と限界、情シスが取るべき構えを実務目線で整理します。 2026.07.01 研究・論文
 研究・論文